Khi dataset tăng lên hàng TB, việc lưu trữ dữ liệu và cấp dữ liệu kịp thời cho GPU trở thành một phần quan trọng của hệ thống AI training. Object Storage cho AI training phù hợp để lưu dataset gốc, dữ liệu đã xử lý, model và checkpoint với khả năng mở rộng linh hoạt. Tuy nhiên, Object Storage không phải lúc nào cũng là nơi đọc dữ liệu tối ưu nhất trong quá trình huấn luyện. Với workload cần truy cập lặp lại và độ trễ thấp, doanh nghiệp có thể kết hợp S3 Object Storage với NVMe cache hoặc File Storage để cải thiện hiệu năng. Bài viết này hướng dẫn cách lựa chọn kiến trúc, đánh giá dịch vụ và ước tính chi phí lưu trữ dữ liệu AI.
Vì sao AI training cần Object Storage?
Object Storage là mô hình lưu trữ dữ liệu dưới dạng các object, thường gồm nội dung dữ liệu, metadata và định danh object. Thay vì tổ chức dữ liệu như các block trên ổ đĩa hoặc dựa hoàn toàn vào cấu trúc thư mục của hệ thống file, Object Storage cho phép ứng dụng quản lý và truy xuất dữ liệu thông qua API.
Trong AI training, dữ liệu có thể tăng nhanh theo số lượng mẫu, độ phân giải hình ảnh, thời lượng video, kích thước tập dữ liệu văn bản và số phiên bản được tạo ra trong quá trình xử lý. Nếu lưu toàn bộ dữ liệu trên máy chủ huấn luyện, việc mở rộng dung lượng có thể làm tăng chi phí và khiến công tác quản lý dữ liệu giữa nhiều dự án trở nên phức tạp.
Object Storage giúp tách lớp lưu trữ dữ liệu khỏi tài nguyên tính toán. Doanh nghiệp có thể mở rộng kho dữ liệu mà không nhất thiết phải mở rộng CPU hoặc GPU tương ứng, đồng thời duy trì một nơi lưu trữ tập trung cho nhiều giai đoạn của pipeline AI.
| Loại dữ liệu | Vai trò của Object Storage | Lưu ý khi sử dụng |
| Dataset gốc | Lưu dữ liệu thu thập từ nhiều nguồn | Cần quản lý phiên bản và quyền truy cập |
| Dataset đã xử lý | Lưu dữ liệu chuẩn hóa, chia tập train/validation/test | Theo dõi phiên bản để tái lập thí nghiệm |
| Model và artifact | Lưu trọng số, cấu hình và kết quả huấn luyện | Quản lý metadata để xác định phiên bản tương ứng |
| Checkpoint | Lưu trạng thái huấn luyện để khôi phục khi cần | Kiểm tra tính toàn vẹn trước khi sử dụng |
| Log và kết quả thí nghiệm | Lưu lịch sử, báo cáo và dữ liệu đầu ra | Xác định thời gian lưu giữ phù hợp |
Object Storage đặc biệt hữu ích khi nhiều dự án cần dùng chung dataset, dữ liệu phải được lưu lâu hơn vòng đời của một máy chủ GPU hoặc doanh nghiệp cần tăng dung lượng theo tốc độ phát triển của dữ liệu.
Dù vậy, lưu trữ tập trung không tự động giải quyết bài toán hiệu năng. Tốc độ cấp dữ liệu cho GPU còn phụ thuộc vào cách tổ chức file, số worker đọc dữ liệu, mạng, API và năng lực xử lý của dịch vụ lưu trữ.
So sánh Object Storage, Block Storage và File Storage cho AI training
Ba loại lưu trữ có thể cùng xuất hiện trong một hệ thống AI, nhưng đảm nhiệm những vai trò khác nhau. Lựa chọn phù hợp cần dựa trên cách ứng dụng đọc, ghi và chia sẻ dữ liệu thay vì chỉ so sánh dung lượng hoặc đơn giá trên mỗi GB.
| Tiêu chí | Object Storage | Block Storage | File Storage |
| Mô hình truy cập | Thông qua API, thường theo object | Truy cập các block như thiết bị lưu trữ | Truy cập qua hệ thống file |
| Khả năng mở rộng | Phù hợp kho dữ liệu lớn, mở rộng linh hoạt | Phụ thuộc nền tảng và cách cấp phát volume | Phụ thuộc hệ thống file và hạ tầng triển khai |
| Độ trễ | Phụ thuộc API, mạng và dịch vụ | Có thể phù hợp workload cần truy cập block với độ trễ thấp | Phụ thuộc giao thức, mạng và hệ thống file |
| Chia sẻ giữa nhiều node | Có thể qua API nếu dịch vụ và quyền truy cập cho phép | Cần cơ chế gắn volume và chia sẻ phù hợp | Thường thuận tiện khi nhiều node cần truy cập chung cây thư mục |
| Tác vụ AI thường gặp | Dataset gốc, model, checkpoint, archive | Đĩa làm việc, cache, dữ liệu cần truy cập block | Dataset cần giao diện file chung, dữ liệu chia sẻ giữa worker |
| Yếu tố chi phí | Dung lượng, request, truyền dữ liệu và dịch vụ bổ sung | Dung lượng volume, hiệu năng và tài nguyên liên quan | Dung lượng, thông lượng, kết nối và mức dịch vụ |
Bảng trên mô tả các đặc điểm phổ biến, không phải cam kết hiệu năng cố định cho mọi sản phẩm. Một dịch vụ Object Storage được tối ưu tốt có thể đáp ứng nhiều workload đọc dữ liệu, trong khi một hệ thống File Storage hoặc Block Storage cụ thể vẫn có thể trở thành nút thắt nếu cấu hình không phù hợp.
Khi nào Object Storage chưa đủ? Nếu mỗi bước huấn luyện cần đọc lặp lại nhiều file nhỏ, yêu cầu truy cập theo đường dẫn hệ thống file hoặc cần độ trễ thấp và ổn định, việc đọc trực tiếp từ Object Storage có thể không phải lựa chọn tối ưu. Khi đó, doanh nghiệp nên cân nhắc cache trên NVMe, nạp trước dữ liệu hoặc sử dụng File Storage phù hợp với workload.
>>>> Đọc thêm bài viết: Object Storage khác File Storage như thế nào? So sánh chi tiết A-Z
Kiến trúc Object Storage cho AI training
Một kiến trúc phổ biến là sử dụng Object Storage làm kho dữ liệu gốc, NVMe làm vùng đệm cho dữ liệu nóng và GPU training nodes làm lớp xử lý. Mô hình này tách nhu cầu lưu trữ dài hạn khỏi nhu cầu truy cập dữ liệu thường xuyên trong quá trình huấn luyện.
1. Luồng dữ liệu từ dataset đến GPU
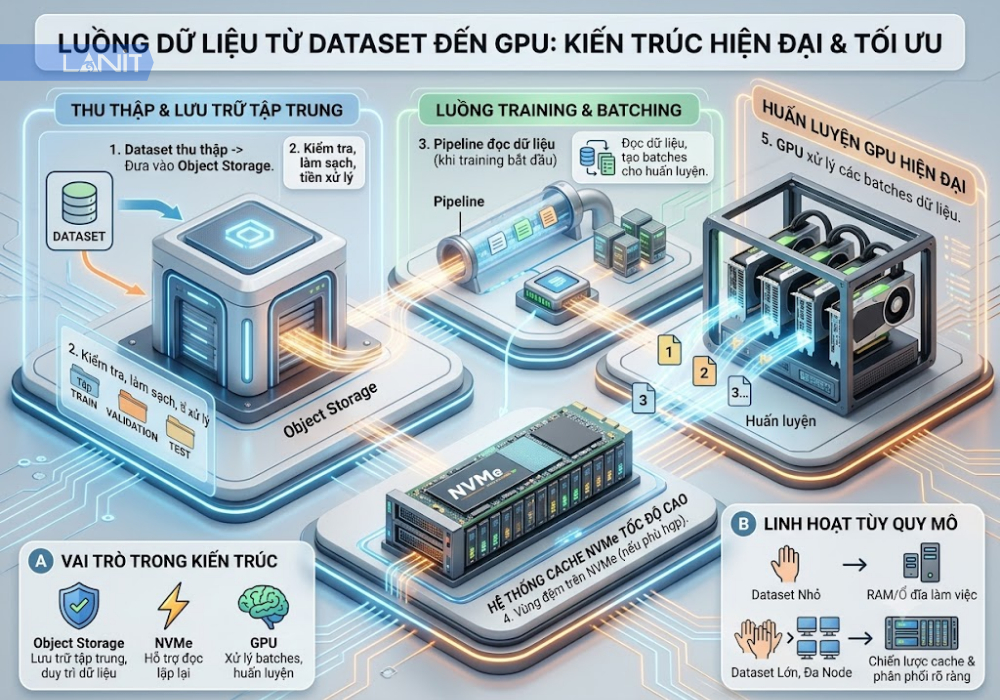
Đầu tiên, dataset được thu thập và đưa vào Object Storage. Sau bước kiểm tra, làm sạch và tiền xử lý, dữ liệu có thể được tổ chức thành các tập train, validation và test. Khi bắt đầu training, pipeline đọc dữ liệu cần thiết từ kho lưu trữ, đưa vào vùng đệm trên NVMe nếu phù hợp, rồi cung cấp các batch cho tiến trình huấn luyện.
Trong kiến trúc này, Object Storage đảm nhiệm việc lưu trữ tập trung và duy trì dữ liệu qua nhiều phiên huấn luyện. NVMe hỗ trợ các lần đọc lặp lại, còn GPU xử lý các batch dữ liệu đã được chuẩn bị.
Không phải dự án nào cũng cần đủ ba lớp. Dataset nhỏ có thể được tải vào RAM hoặc ổ đĩa làm việc. Dataset lớn, được nhiều node sử dụng hoặc cần tái sử dụng qua nhiều vòng huấn luyện, thường cần chiến lược cache và phân phối dữ liệu rõ ràng hơn.
2. Lưu checkpoint và khôi phục mô hình
Checkpoint là bản lưu trạng thái huấn luyện tại một thời điểm. Tùy framework và phương pháp training, checkpoint có thể chứa trọng số mô hình, trạng thái optimizer, bộ đếm bước huấn luyện và các thông tin cần thiết để tiếp tục quá trình đang thực hiện.
Doanh nghiệp có thể ghi checkpoint vào vùng lưu trữ cục bộ trước, sau đó đồng bộ lên Object Storage theo chu kỳ. Cách triển khai này cần bảo đảm dữ liệu được ghi hoàn chỉnh trước khi coi checkpoint là bản có thể khôi phục. Nếu ghi trực tiếp lên Object Storage, ứng dụng cũng cần xử lý lỗi truyền dữ liệu và xác nhận kết quả ghi.
Tần suất checkpoint nên dựa trên thời gian cần để huấn luyện lại, chi phí ghi dữ liệu và mức độ chấp nhận mất tiến trình. Ghi quá thường xuyên có thể tạo thêm tải I/O; ghi quá thưa làm tăng lượng công việc có nguy cơ phải thực hiện lại khi xảy ra sự cố.
Object Storage cũng không nên được xem là cơ chế backup hoàn chỉnh chỉ vì đã lưu checkpoint. Doanh nghiệp cần có chính sách phiên bản, kiểm tra khả năng khôi phục và phân quyền phù hợp.
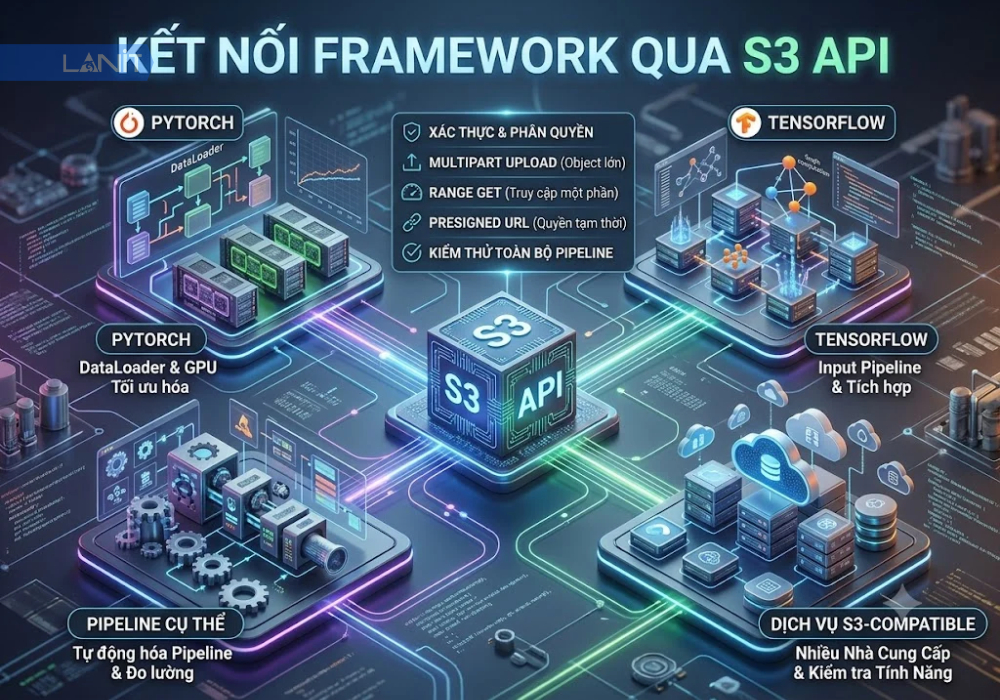
3. Kết nối framework qua S3 API
Với dịch vụ tương thích S3, ứng dụng có thể sử dụng API, SDK hoặc công cụ hỗ trợ giao thức để đọc và ghi object. Tuy nhiên, việc tích hợp với PyTorch, TensorFlow hoặc một pipeline cụ thể còn phụ thuộc thư viện trung gian, định dạng dữ liệu và cách framework triển khai DataLoader hoặc input pipeline.
Khi thiết kế kết nối, cần kiểm tra khả năng xác thực, phân quyền, xử lý lỗi, retry và cách ứng dụng đọc dữ liệu theo từng object. Multipart upload có thể hữu ích với object lớn; range GET cho phép yêu cầu một phần dữ liệu khi dịch vụ hỗ trợ; presigned URL có thể cấp quyền truy cập tạm thời trong phạm vi được cấu hình.
Các khả năng này cần được kiểm tra theo API và giới hạn của nhà cung cấp. Không nên mặc định mọi dịch vụ S3-compatible đều hỗ trợ tất cả tính năng với cùng hành vi hoặc hiệu năng.
Tài liệu Data Loading Optimization của PyTorch cũng nhấn mạnh vai trò của việc đo và tối ưu DataLoader, số worker, prefetch và khả năng chồng lấp quá trình nạp dữ liệu với tính toán GPU. Vì vậy, cần kiểm thử toàn bộ pipeline thay vì chỉ đo tốc độ đọc của hệ thống lưu trữ.
4. Tiêu chí kỹ thuật và cách kiểm chứng Object Storage cho AI training
Để chọn được dịch vụ phù hợp, doanh nghiệp nên đánh giá trên workload gần với thực tế. Một con số throughput cao trong điều kiện thử nghiệm đơn giản không bảo đảm GPU sẽ luôn nhận dữ liệu đủ nhanh khi chạy training nhiều worker hoặc nhiều node.
| Tiêu chí | Cách kiểm chứng | Ý nghĩa đối với AI training |
| Throughput đọc/ghi | Đo lượng dữ liệu đọc hoặc ghi mỗi giây với object và kích thước phù hợp | Xác định khả năng cấp dữ liệu cho pipeline |
| Độ trễ | Đo thời gian phản hồi ở nhiều mức tải | Phát hiện tình trạng chờ khi đọc dữ liệu |
| Request đồng thời | Tăng dần số worker và theo dõi lỗi, độ trễ, throughput | Đánh giá khả năng phục vụ nhiều tiến trình |
| Kích thước object | Thử với file lớn và tập hợp nhiều file nhỏ | Xác định cách tổ chức dataset hiệu quả |
| Tính tương thích API | Kiểm tra các thao tác cần thiết bằng SDK hoặc công cụ dự kiến sử dụng | Tránh lỗi tích hợp khi triển khai |
| Quản lý phiên bản | Thử ghi đè, truy xuất phiên bản và khôi phục theo chính sách | Hạn chế rủi ro sử dụng nhầm dữ liệu |
| Bảo mật và logging | Kiểm tra quyền truy cập, thu hồi khóa và khả năng theo dõi hoạt động | Kiểm soát truy cập và hỗ trợ điều tra sự cố |
Khi benchmark, nên sử dụng dataset đại diện cho workload thật, gồm kích thước file, số lượng object, kiểu truy cập và mức độ song song tương tự môi trường sản xuất. Đo riêng hiệu năng đọc tuần tự, đọc nhiều object và tải dữ liệu khi nhiều worker cùng hoạt động.
Một quy trình kiểm thử hữu ích gồm ba bước:
- Đo đường cơ sở: xác định thời gian đọc dữ liệu và tốc độ training khi dataset đã nằm trên NVMe cục bộ.
- Đo khi đọc từ Object Storage: sử dụng cùng dataset, cấu hình batch và workload tương đương; ghi lại throughput, độ trễ, lỗi và thời gian mỗi epoch.
- Đo khi bật cache hoặc nạp trước dữ liệu: so sánh mức sử dụng GPU, thời gian training và tổng chi phí vận hành.
Nếu GPU thường xuyên chờ dữ liệu, cần xác định nguyên nhân trước khi tăng tài nguyên. Nút thắt có thể nằm ở giải mã ảnh, tiền xử lý CPU, số worker, mạng hoặc dịch vụ lưu trữ. Tăng số worker không phải lúc nào cũng cải thiện hiệu năng; cần theo dõi kết quả đến khi throughput không tăng thêm hoặc tài nguyên khác trở thành giới hạn.
Các thông số riêng của nhà cung cấp như throughput cam kết, giới hạn request đồng thời, kích thước object tối đa và hỗ trợ multipart upload hoặc range GET cần được xác minh trước khi lựa chọn. Với dịch vụ LANIT, những thông số chưa có xác nhận chính thức cần được đánh dấu [CẦN XÁC MINH].
Cách tính chi phí lưu trữ dataset AI
Chi phí Object Storage không chỉ phụ thuộc vào dung lượng dataset. Một pipeline AI có thể đọc cùng một dữ liệu nhiều lần qua nhiều epoch, tạo ra lượng request và lưu lượng truyền dữ liệu lớn hơn đáng kể so với dung lượng đang lưu.
Công thức ước tính tổng quát:
Tổng chi phí tháng = Chi phí lưu trữ + Chi phí request + Chi phí truyền dữ liệu + Chi phí phụ trợ.
Chi phí lưu trữ phụ thuộc dung lượng tính phí trung bình và đơn giá của nhà cung cấp. Chi phí request phụ thuộc số thao tác đọc, ghi, liệt kê object và biểu phí áp dụng. Chi phí truyền dữ liệu phụ thuộc lượng dữ liệu đi qua các phạm vi tính phí của dịch vụ. Chi phí phụ trợ có thể gồm NVMe cache, máy chủ xử lý dữ liệu, mạng và công cụ quản lý.
Ví dụ, một doanh nghiệp có dataset 2 TB và cần đọc lại dữ liệu qua nhiều vòng training. Giả sử dung lượng tính phí trung bình là 2.000 GB, đơn giá minh họa là 800 đồng/GB/tháng, thì chi phí lưu trữ cơ bản là:
2.000 × 800 = 1.600.000 đồng/tháng.
Đây chỉ là ví dụ giả định để minh họa phép tính, không phải báo giá của LANIT hay một nhà cung cấp cụ thể. Chi phí thực tế cần căn cứ vào cách tính dung lượng, đơn giá và chính sách tính phí hiện hành.
Nếu mỗi epoch đọc toàn bộ 2 TB dữ liệu và mô hình chạy 20 epoch, lượng dữ liệu đọc logic có thể lên tới khoảng 40 TB, chưa tính các thao tác phụ. Con số này không nhất thiết bằng lượng egress phải trả phí: việc tính phí còn phụ thuộc đường đi của dữ liệu, cache, phạm vi miễn phí và chính sách nhà cung cấp.
Để dự toán sát thực tế, doanh nghiệp nên ghi nhận dung lượng trung bình, số epoch dự kiến, lượng dữ liệu thực sự được đọc, số request và tỷ lệ cache hit. Sau đó, hãy so sánh tổng chi phí giữa phương án đọc trực tiếp từ Object Storage và phương án kết hợp NVMe cache.
Chọn Object Storage tại Việt Nam: những yếu tố cần cân nhắc
Với doanh nghiệp có cụm GPU hoặc đội ngũ vận hành tại Việt Nam, vị trí lưu trữ là một yếu tố đáng cân nhắc. Tuy nhiên, đặt dữ liệu trong nước không tự động bảo đảm độ trễ thấp nhất. Hiệu năng thực tế còn phụ thuộc vào tuyến mạng, băng thông, điểm truy cập và khoảng cách giữa hệ thống lưu trữ với node huấn luyện.
Trước khi lựa chọn, doanh nghiệp nên kiểm tra ba yếu tố.
Thứ nhất, vị trí hạ tầng và kết nối mạng. Nên đo thời gian phản hồi và throughput từ chính môi trường GPU dự kiến sử dụng, thay vì chỉ dựa vào vị trí địa lý được công bố.
Thứ hai, SLA và hỗ trợ kỹ thuật. Cần làm rõ phạm vi cam kết, thời gian xử lý sự cố, kênh hỗ trợ và trách nhiệm của các bên. Nếu training chạy theo lịch hoặc sử dụng GPU có chi phí cao, sự cố cấp dữ liệu có thể ảnh hưởng trực tiếp đến hiệu quả vận hành.
Thứ ba, quản trị và kiểm soát dữ liệu. Xác định ai được truy cập dataset, dữ liệu cần giữ trong bao lâu, cách thu hồi quyền truy cập và quy trình chuyển dữ liệu khi thay đổi nhà cung cấp. Với dữ liệu nhạy cảm, cần đánh giá thêm các yêu cầu nội bộ và quy định áp dụng cho tổ chức.
Checklist chọn nhà cung cấp Object Storage cho AI training
Trước khi ký hợp đồng, doanh nghiệp có thể tự kiểm tra các câu hỏi sau:
- Hiệu năng: Dịch vụ đã được benchmark với workload và môi trường GPU thực tế chưa? Xem tiêu chí đo ở mục 4.
- Tổng chi phí: Đã tính dung lượng, request, egress, cache và các dịch vụ phụ trợ chưa?
- SLA: Phạm vi uptime, quy trình thông báo và hỗ trợ khi có sự cố có rõ ràng không?
- Hỗ trợ kỹ thuật: Nhà cung cấp có hỗ trợ tích hợp, kiểm thử và xử lý lỗi kết nối hay không?
- Vị trí lưu trữ: Kết nối từ cụm GPU đến dịch vụ có đáp ứng yêu cầu về độ trễ và thông lượng không?
- Di chuyển dữ liệu: Có phương án đồng bộ, kiểm tra tính toàn vẹn và chuyển dữ liệu ra khỏi dịch vụ khi cần không?
- Tích hợp pipeline: API và công cụ có tương thích với framework, script và quy trình vận hành hiện tại không?
- Quản trị dữ liệu: Có thể thiết lập quyền truy cập, chính sách lưu giữ và quy trình khôi phục phù hợp không?
Không nên chọn nhà cung cấp chỉ dựa trên giá lưu trữ thấp nhất hoặc tuyên bố tương thích S3. Quyết định cuối cùng nên dựa trên kết quả kiểm thử, tổng chi phí và mức độ phù hợp với workload trong suốt vòng đời dự án.
S3 Object Storage của LANIT cho AI training
S3 Object Storage của LANIT có thể được sử dụng để lưu trữ tập dữ liệu (dataset), model, checkpoint và dữ liệu đầu ra trong quá trình huấn luyện AI. Giải pháp này giúp doanh nghiệp quản lý dữ liệu tập trung, đồng thời tách dung lượng lưu trữ khỏi tài nguyên tính toán như CPU và GPU.
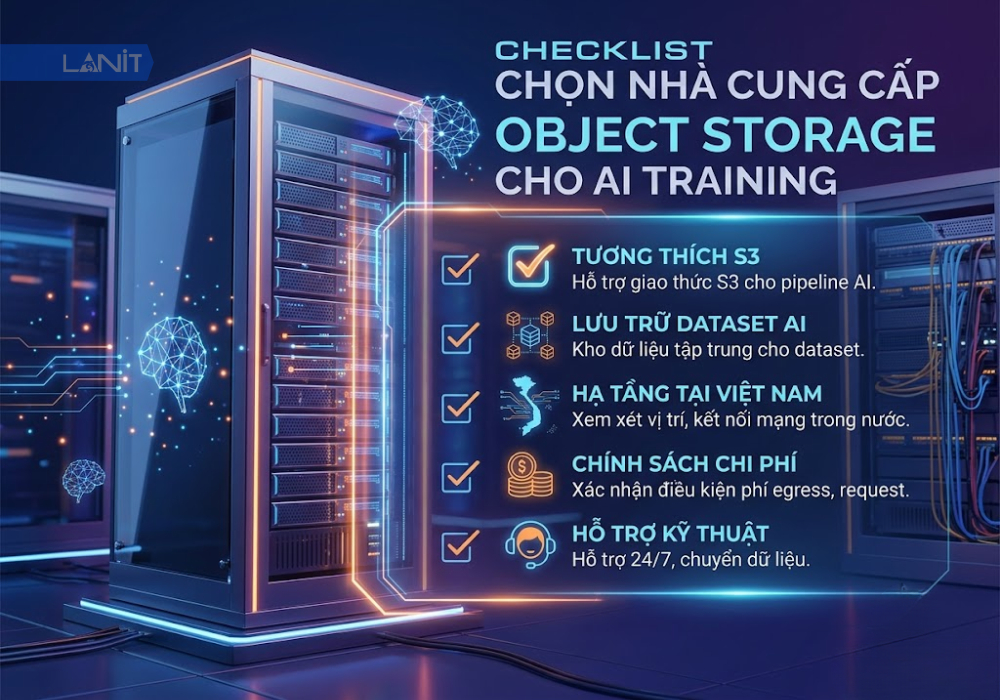
Với dịch vụ S3 Object Storage của LANIT, doanh nghiệp có thể yên tâm với những điểm sau:
- Tương thích S3: Hỗ trợ tích hợp với ứng dụng và công cụ sử dụng giao thức S3, tùy thuộc vào API mà pipeline AI yêu cầu.
- Lưu trữ dataset AI: Có thể sử dụng làm kho dữ liệu tập trung cho dataset và các file phục vụ quá trình huấn luyện.
- Hạ tầng tại Việt Nam: Thuận tiện cho doanh nghiệp muốn xem xét vị trí lưu trữ và kết nối mạng trong nước.
- Chính sách chi phí: LANIT công bố không tính phí egress và request theo chính sách dịch vụ. Doanh nghiệp nên xác nhận điều kiện áp dụng khi nhận báo giá.
- Hỗ trợ kỹ thuật: LANIT công bố hỗ trợ 24/7 và hỗ trợ chuyển dữ liệu từ nhà cung cấp khác.
Để sử dụng hiệu quả cho AI training, doanh nghiệp nên xác định rõ dung lượng dataset, số lượng file, tần suất đọc và số node GPU cần truy cập dữ liệu. Nếu mô hình phải đọc đi đọc lại cùng một tập dữ liệu, có thể kết hợp Object Storage với NVMe cache để giảm thời gian chờ dữ liệu.
Một điểm cần lưu ý là tương thích S3 không đồng nghĩa với việc tốc độ đọc luôn đáp ứng mọi nhu cầu huấn luyện AI. Trước khi triển khai, doanh nghiệp nên kiểm thử hiệu năng trên môi trường thực tế và xác nhận các giới hạn kỹ thuật, SLA cùng chính sách giá của dịch vụ.
Câu hỏi thường gặp về Object Storage cho AI training
Object Storage có đủ nhanh để huấn luyện mô hình AI không?
Có thể, tùy workload và hiệu năng dịch vụ. Cần đo throughput, độ trễ và mức sử dụng GPU khi đọc dữ liệu thực tế. Với dữ liệu được đọc lặp nhiều lần, NVMe cache có thể giúp giảm thời gian chờ.
Nên lưu dataset AI trên Object Storage hay Block Storage?
Object Storage phù hợp làm kho dataset tập trung và mở rộng dài hạn. Block Storage có thể phù hợp hơn cho dữ liệu làm việc cần truy cập theo block hoặc cần độ trễ thấp. Hai loại có thể kết hợp trong cùng một hệ thống.
Checkpoint mô hình AI nên lưu ở đâu?
Checkpoint có thể được lưu trên NVMe trong lúc ghi rồi đồng bộ lên Object Storage, hoặc ghi trực tiếp nếu ứng dụng và dịch vụ đáp ứng yêu cầu. Cần xác nhận dữ liệu ghi hoàn chỉnh và kiểm tra khả năng khôi phục.
Có thể kết nối Object Storage với PyTorch và TensorFlow như thế nào?
Có thể tích hợp thông qua API, SDK hoặc thư viện hỗ trợ S3 tùy pipeline. Cần kiểm tra cách framework đọc dữ liệu, xử lý xác thực và tương thích với các thao tác mà dịch vụ cung cấp.
Chi phí lưu dataset AI gồm những khoản nào?
Các khoản có thể gồm dung lượng lưu trữ, request, truyền dữ liệu, máy chủ xử lý, cache và công cụ phụ trợ. Một số nhà cung cấp miễn một hoặc nhiều loại phí, vì vậy cần đối chiếu biểu phí cụ thể.
Làm thế nào để kiểm tra hiệu năng Object Storage trước khi sử dụng?
Hãy benchmark bằng dataset đại diện, đo throughput và độ trễ, thử nhiều worker đồng thời, sau đó so sánh thời gian training và mức sử dụng GPU với phương án đọc từ NVMe cục bộ.
Kết luận
Object Storage cho AI training giúp doanh nghiệp quản lý dataset, model và checkpoint tập trung, đồng thời mở rộng dung lượng mà không phải tăng tài nguyên GPU tương ứng. Tuy nhiên, hiệu quả của hệ thống phụ thuộc vào kiến trúc dữ liệu, cách cấp dữ liệu cho GPU, khả năng kiểm thử hiệu năng và tổng chi phí vận hành.
Với workload đọc lặp hoặc yêu cầu độ trễ thấp, doanh nghiệp nên cân nhắc kết hợp Object Storage với NVMe cache hoặc File Storage thay vì mặc định đọc trực tiếp từ kho object. Trước khi lựa chọn dịch vụ, hãy benchmark trên workload thực tế và xác minh các giới hạn kỹ thuật, chính sách giá cùng SLA.