Khi một ứng dụng phát triển từ một dịch vụ đơn lẻ thành hệ thống gồm nhiều microservices, việc theo dõi hiệu suất và tìm nguyên nhân sự cố trở nên phức tạp hơn. Mỗi dịch vụ có thể sử dụng một công cụ giám sát khác nhau, khiến dữ liệu phân tán và khó liên kết. OpenTelemetry ra đời nhằm giải quyết vấn đề này bằng cách chuẩn hóa quá trình tạo, thu thập và xuất dữ liệu quan sát từ ứng dụng.
Vậy OpenTelemetry là gì, hoạt động như thế nào và có thể triển khai ra sao trên Kubernetes hoặc Cloud Server? Bài viết dưới đây sẽ giúp bạn hiểu rõ kiến trúc, các thành phần quan trọng và cách bắt đầu sử dụng công cụ này trong thực tế.
OpenTelemetry là gì?
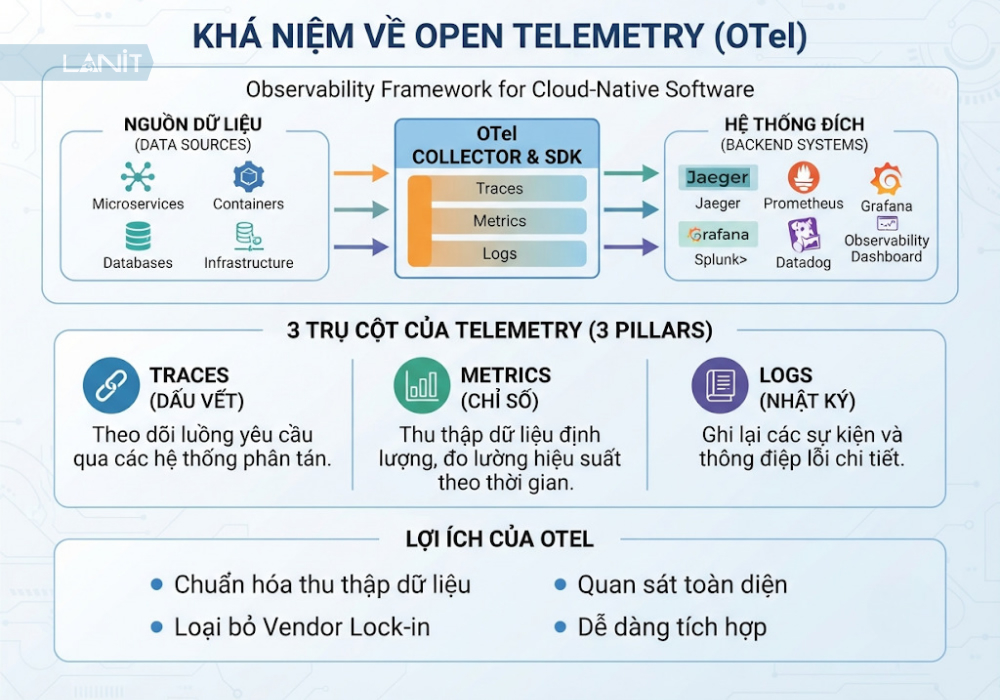
OpenTelemetry (OTel) là framework mã nguồn mở, trung lập nhà cung cấp, cung cấp các API, SDK và công cụ để instrument, tạo, thu thập và xuất dữ liệu telemetry như traces, metrics và logs. Nhờ đó, developer và đội ngũ vận hành có thể theo dõi hiệu suất, phân tích hành vi và phát hiện vấn đề trong ứng dụng.
Điểm quan trọng cần phân biệt là OpenTelemetry không phải một nền tảng observability hoàn chỉnh. Công cụ này không trực tiếp đảm nhiệm việc lưu trữ, truy vấn hay trực quan hóa dữ liệu. Thay vào đó, OpenTelemetry cung cấp một tiêu chuẩn chung để ứng dụng gửi dữ liệu đến các hệ thống backend như Prometheus, Jaeger, Grafana hoặc những nền tảng APM thương mại.
OpenTelemetry được hình thành vào năm 2019 từ sự hợp nhất của hai dự án mã nguồn mở là OpenTracing và OpenCensus. Cả hai đều hướng đến mục tiêu chuẩn hóa cách instrument ứng dụng và gửi dữ liệu quan sát đến hệ thống giám sát. Việc hợp nhất giúp cộng đồng phát triển một hệ sinh thái thống nhất thay vì duy trì nhiều tiêu chuẩn riêng biệt.
Dự án được quản lý trong hệ sinh thái Cloud Native Computing Foundation (CNCF). Đến tháng 5/2026, OpenTelemetry chính thức đạt trạng thái Graduated của CNCF, thể hiện mức độ trưởng thành, khả năng ứng dụng trong môi trường production và sự phát triển của cộng đồng.
Nhờ thiết kế trung lập nhà cung cấp, OpenTelemetry cho phép doanh nghiệp thay đổi hệ thống backend mà không nhất thiết phải viết lại toàn bộ mã instrumentation trong ứng dụng. Đây là lợi thế quan trọng đối với các hệ thống phân tán và kiến trúc microservices.
Các loại tín hiệu và dữ liệu ngữ cảnh trong OpenTelemetry
Telemetry là dữ liệu được tạo ra từ hoạt động của ứng dụng, máy chủ và các thành phần hạ tầng. Thông qua những dữ liệu này, đội ngũ kỹ thuật có thể hiểu hệ thống đang hoạt động như thế nào, phát hiện điểm nghẽn và tìm nguyên nhân gây lỗi.
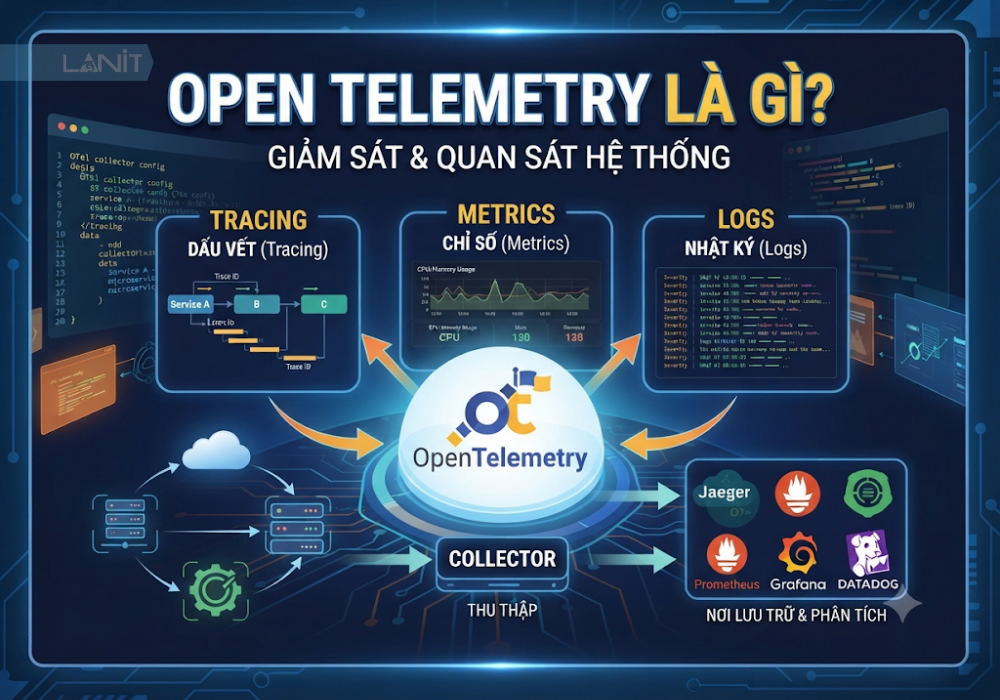
OpenTelemetry tập trung vào ba loại tín hiệu quan sát cốt lõi gồm Traces, Metrics và Logs. Bên cạnh đó, Baggage và Context Propagation giúp truyền thông tin ngữ cảnh giữa các thành phần trong hệ thống.
1. Traces: Theo dõi hành trình của request
Trace ghi lại toàn bộ hành trình của một request khi đi qua nhiều thành phần trong ứng dụng. Mỗi trace bao gồm một hoặc nhiều span, trong đó mỗi span đại diện cho một thao tác hoặc một khoảng thời gian xử lý cụ thể.
Ví dụ, khi người dùng đặt hàng trên website, request có thể đi qua các thành phần:
- API Gateway tiếp nhận yêu cầu.
- Order Service xử lý thông tin đơn hàng.
- Payment Service thực hiện thanh toán.
- Database ghi nhận giao dịch.
- Notification Service gửi thông báo xác nhận.
Một trace có thể liên kết các hoạt động trên thành một hành trình thống nhất. Mỗi span lưu thông tin như thời gian bắt đầu, thời lượng xử lý, trạng thái thành công hoặc lỗi và các thuộc tính liên quan.
Nhờ distributed tracing, developer có thể xác định dịch vụ nào đang xử lý chậm, request bị lỗi ở bước nào hoặc thời gian phản hồi tăng lên do truy vấn cơ sở dữ liệu hay do giao tiếp giữa các microservices.
2. Metrics: Đo lường hiệu suất hệ thống
Metrics là các số liệu được ghi nhận theo thời gian, phản ánh trạng thái và hiệu suất của ứng dụng hoặc hạ tầng.
Một số chỉ số phổ biến gồm:
- CPU Usage: Mức sử dụng CPU của máy chủ.
- Memory Usage: Dung lượng RAM đang sử dụng.
- Request Rate: Số lượng request được xử lý trong một khoảng thời gian.
- Error Rate: Tỷ lệ request gặp lỗi.
- Request Duration: Thời gian xử lý request.
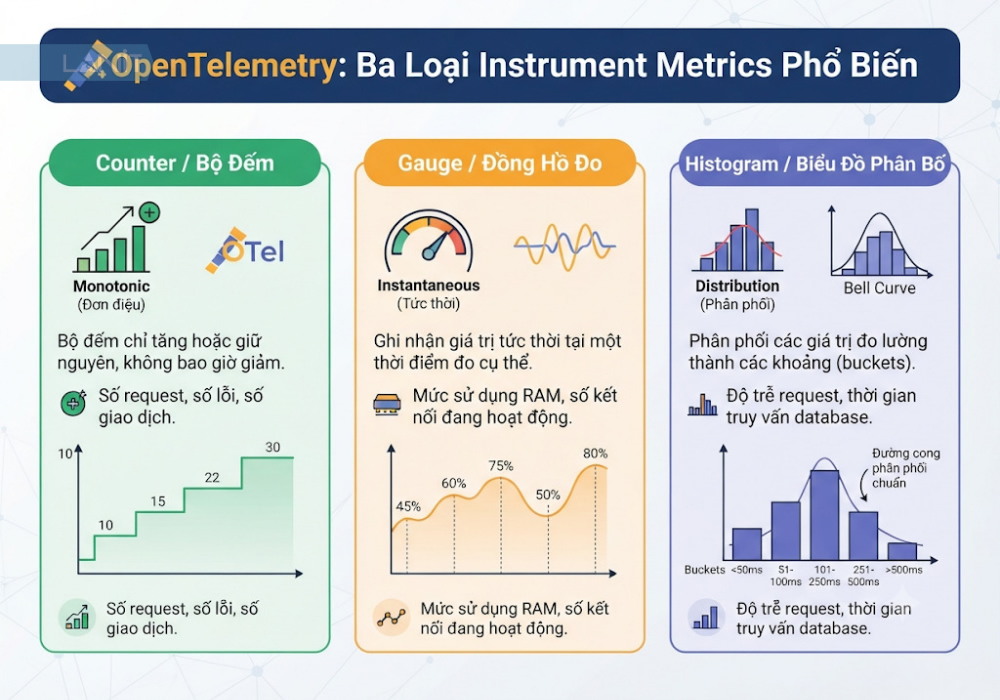
OpenTelemetry hỗ trợ ba loại instrument metrics thường gặp:
- Counter: Bộ đếm chỉ tăng hoặc giữ nguyên, phù hợp để ghi nhận số request, số lỗi hoặc số giao dịch.
- Gauge: Ghi nhận giá trị tại một thời điểm, chẳng hạn mức sử dụng RAM hoặc số kết nối đang hoạt động.
- Histogram: Phân phối các giá trị đo lường thành các khoảng, thường dùng để phân tích độ trễ request hoặc thời gian truy vấn database.
Metrics giúp đội ngũ vận hành nhận biết xu hướng bất thường, thiết lập cảnh báo và đánh giá năng lực xử lý của hệ thống.
3. Logs: Ghi nhận sự kiện ứng dụng
Logs là các bản ghi mô tả sự kiện xảy ra trong quá trình ứng dụng hoạt động. Chúng thường chứa thời gian, mức độ nghiêm trọng, nội dung thông báo và thông tin bổ sung về sự kiện.
Ví dụ, khi một request không thể kết nối đến database, ứng dụng có thể ghi lại log với nội dung lỗi kết nối, tên dịch vụ, thời điểm xảy ra và thông tin liên quan.
OpenTelemetry hỗ trợ thu thập và xuất logs theo cấu trúc thống nhất. Đặc biệt, logs có thể được liên kết với traces thông qua Trace ID và Span ID.
Khi phát hiện một request bị lỗi, developer có thể sử dụng Trace ID để tìm các bản ghi log tương ứng. Điều này giúp rút ngắn thời gian điều tra sự cố thay vì phải tìm kiếm thủ công trong nhiều nguồn dữ liệu.
4. Baggage và Context Propagation: Truyền ngữ cảnh giữa các dịch vụ
Context Propagation là cơ chế truyền thông tin ngữ cảnh qua các ranh giới giao tiếp giữa những thành phần trong hệ thống. Đây là yếu tố quan trọng giúp OpenTelemetry liên kết các span thuộc cùng một trace.
Baggage là tập hợp các cặp key-value được gắn vào context và truyền qua nhiều dịch vụ. Ví dụ, một request có thể mang theo thông tin về mã khách hàng, nhóm xử lý hoặc phiên bản ứng dụng để các dịch vụ phía sau sử dụng.
Tuy nhiên, Baggage không thay thế các thuộc tính bảo mật hay cơ chế xác thực. Do dữ liệu này có thể được truyền xuyên nhiều dịch vụ, developer cần tránh đưa mật khẩu, token truy cập hoặc thông tin cá nhân nhạy cảm vào Baggage.
Ngoài ba tín hiệu cốt lõi, OpenTelemetry còn phát triển hỗ trợ Profiles để phân tích mức sử dụng tài nguyên của từng đoạn mã. Tính đến năm 2026, Profiles vẫn ở trạng thái Alpha, vì vậy cần phân biệt với Traces, Metrics và Logs đã đạt mức ổn định cao hơn.
Các thành phần chính của OpenTelemetry
OpenTelemetry được xây dựng từ nhiều thành phần phối hợp với nhau để tạo, xử lý và xuất dữ liệu telemetry. Mỗi thành phần đảm nhiệm một nhiệm vụ riêng, từ cung cấp giao diện lập trình đến vận chuyển dữ liệu sang hệ thống giám sát.
1. API và SDK
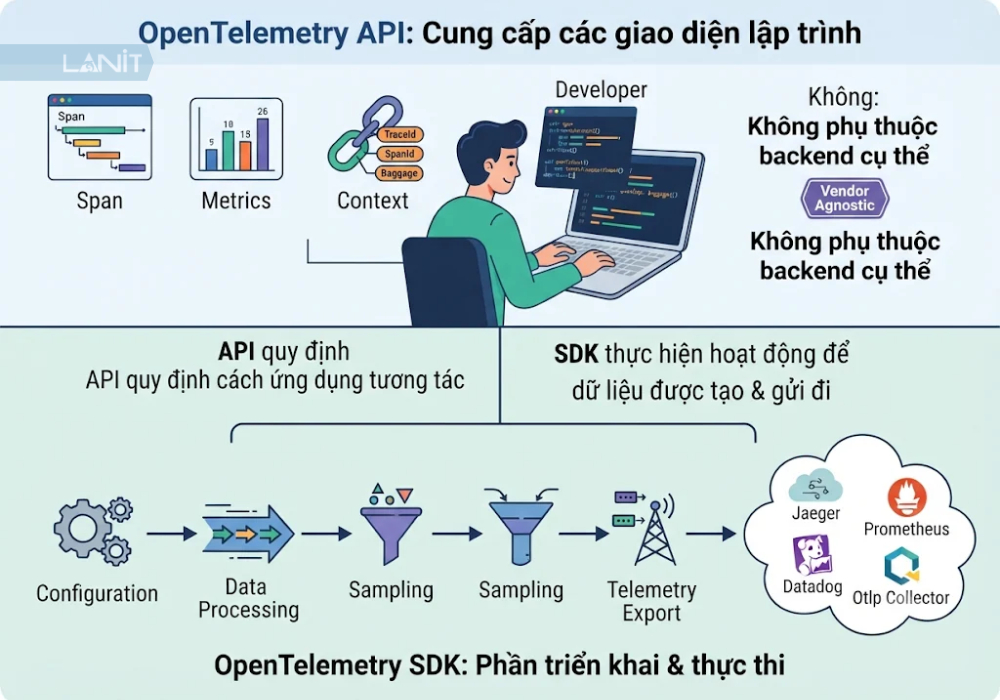
API và SDK là hai thành phần nền tảng trong kiến trúc OpenTelemetry, nhưng có chức năng khác nhau.
- OpenTelemetry API cung cấp các giao diện lập trình để ứng dụng hoặc thư viện tạo dữ liệu telemetry. Developer có thể sử dụng API để tạo span, ghi nhận metrics hoặc liên kết thông tin ngữ cảnh mà không cần phụ thuộc trực tiếp vào một backend cụ thể.
- OpenTelemetry SDK là phần triển khai các giao diện API. SDK đảm nhiệm việc cấu hình, xử lý dữ liệu, áp dụng sampling và xuất telemetry đến các hệ thống tiếp nhận.
- Có thể hiểu đơn giản, API quy định cách ứng dụng tương tác với OpenTelemetry, còn SDK thực hiện những hoạt động cần thiết để dữ liệu được tạo và gửi đi.
OpenTelemetry cung cấp các triển khai theo ngôn ngữ lập trình như Java, Python, JavaScript, Go, .NET, PHP và nhiều ngôn ngữ khác. Mức độ hỗ trợ và độ ổn định có thể khác nhau giữa từng ngôn ngữ và từng thành phần.
2. Instrumentation tự động và thủ công
Instrumentation là quá trình bổ sung khả năng ghi nhận dữ liệu telemetry vào ứng dụng. OpenTelemetry hỗ trợ hai phương thức chính.
Auto-instrumentation (instrumentation tự động) sử dụng các thư viện hoặc agent để tự động ghi nhận dữ liệu từ framework, thư viện và thành phần phổ biến mà không cần sửa nhiều mã nguồn.
Ví dụ, khi tích hợp OpenTelemetry Java Agent vào một ứng dụng Java, hệ thống có thể tự động ghi nhận các request HTTP, truy vấn database hoặc hoạt động của một số thư viện được hỗ trợ.
Phương pháp này phù hợp khi cần triển khai nhanh trên ứng dụng hiện có hoặc muốn thu thập dữ liệu cơ bản trước khi tùy chỉnh sâu hơn.
Manual instrumentation (instrumentation thủ công) yêu cầu developer chủ động gọi API của OpenTelemetry để tạo span, ghi nhận sự kiện hoặc bổ sung thuộc tính theo logic nghiệp vụ.
Ví dụ, một hệ thống thương mại điện tử có thể tạo span riêng cho các bước kiểm tra tồn kho, tính phí vận chuyển và áp dụng mã giảm giá.
Instrumentation thủ công phù hợp với những hoạt động nghiệp vụ đặc thù mà auto-instrumentation không thể tự nhận biết.
Trong thực tế, hai phương pháp thường được kết hợp. Auto-instrumentation thu thập dữ liệu phổ biến, còn manual instrumentation bổ sung thông tin quan trọng theo từng nghiệp vụ.
3. OpenTelemetry Collector
OpenTelemetry Collector là thành phần trung gian có nhiệm vụ tiếp nhận, xử lý và xuất dữ liệu telemetry từ nhiều nguồn khác nhau.
Thay vì để từng ứng dụng kết nối trực tiếp đến nhiều backend, doanh nghiệp có thể sử dụng Collector làm một pipeline tập trung để quản lý dữ liệu.
Collector gồm ba nhóm thành phần chính:
- Receivers: Tiếp nhận dữ liệu từ ứng dụng, SDK hoặc các hệ thống khác. Ví dụ: OTLP Receiver nhận dữ liệu qua giao thức OTLP.
- Processors: Xử lý dữ liệu trước khi xuất đi. Một số tác vụ phổ biến gồm batch, lọc dữ liệu, bổ sung thuộc tính, giới hạn bộ nhớ và sampling.
- Exporters: Chuyển dữ liệu đến backend hoặc hệ thống tiếp nhận khác, chẳng hạn OTLP Exporter hoặc Prometheus Remote Write Exporter.
Các thành phần này được cấu hình thành pipeline riêng cho từng loại tín hiệu. Ví dụ, pipeline traces có thể sử dụng OTLP Receiver, Batch Processor và OTLP Exporter để chuyển dữ liệu đến hệ thống tracing.
Collector có thể chạy dưới dạng agent gần ứng dụng hoặc gateway tập trung. Đây là thành phần đặc biệt hữu ích khi hệ thống có nhiều dịch vụ và cần kiểm soát luồng telemetry thống nhất.
4. OTLP
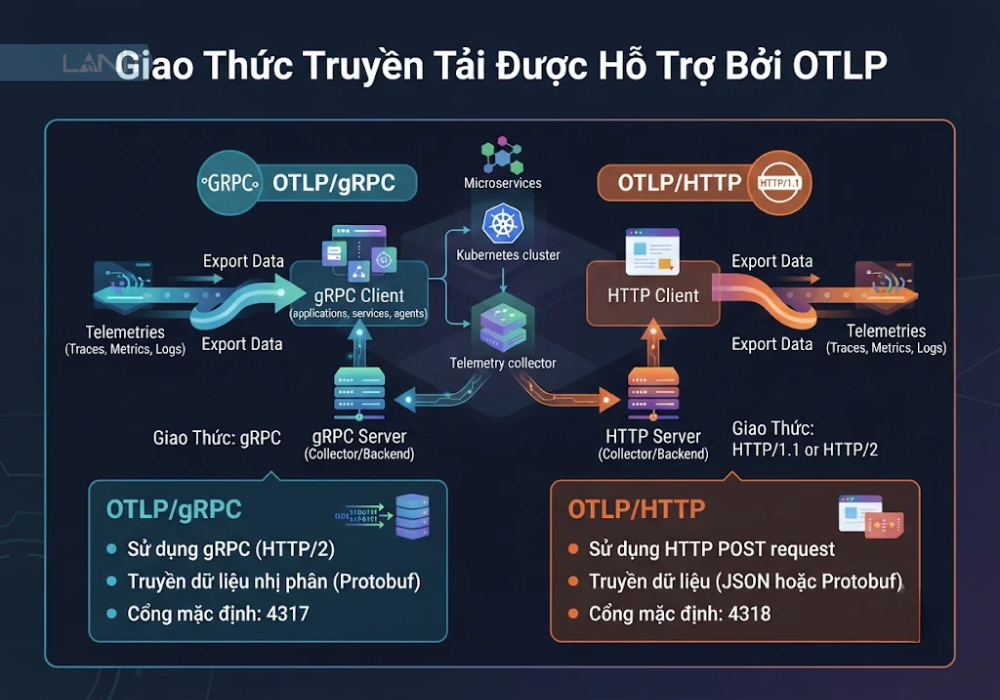
OTLP (OpenTelemetry Protocol) là giao thức chuẩn dùng để truyền dữ liệu telemetry giữa các thành phần OpenTelemetry, chẳng hạn SDK và Collector hoặc giữa các Collector.
OTLP hỗ trợ hai phương thức truyền phổ biến:
- OTLP/gRPC: Sử dụng gRPC, thường chạy trên cổng 4317 theo cấu hình mặc định phổ biến.
- OTLP/HTTP: Sử dụng HTTP, thường chạy trên cổng 4318.
Cả hai phương thức đều có thể truyền dữ liệu theo định dạng Protobuf. OTLP/HTTP cũng hỗ trợ định dạng JSON theo đặc tả giao thức.
Việc sử dụng OTLP giúp các thành phần khác nhau có thể trao đổi dữ liệu theo một chuẩn chung. Nhờ đó, doanh nghiệp dễ dàng kết nối ứng dụng với Collector hoặc thay đổi backend mà không phải xây dựng lại toàn bộ cơ chế truyền telemetry.
OpenTelemetry hoạt động như thế nào?
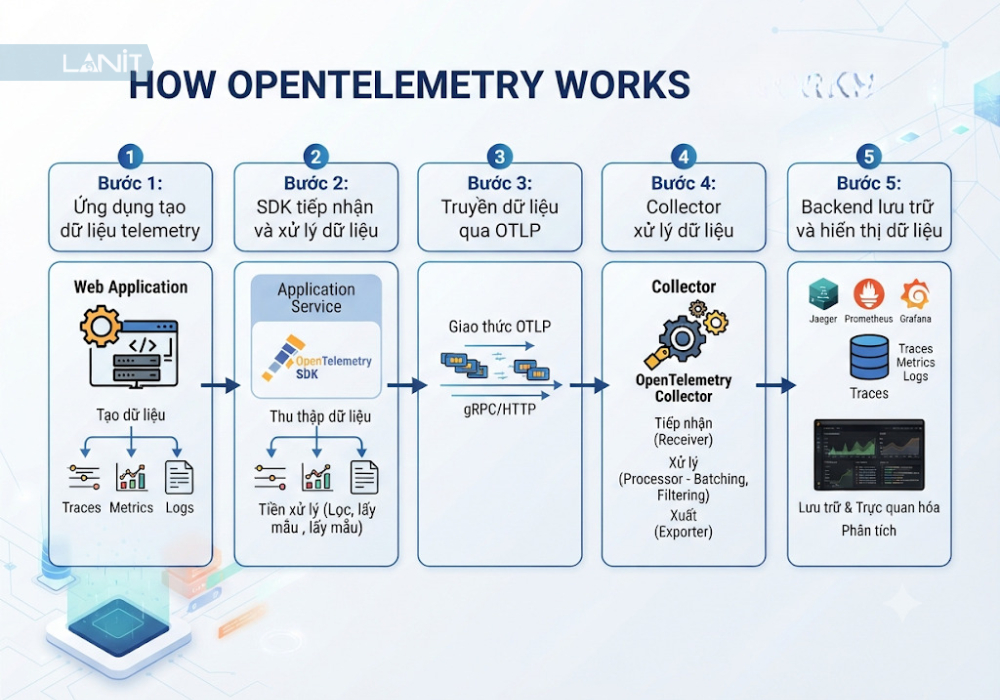
OpenTelemetry hoạt động bằng cách instrument ứng dụng để tạo dữ liệu telemetry, sau đó xử lý và xuất dữ liệu đến hệ thống backend thông qua SDK, OTLP và Collector.
Một luồng triển khai phổ biến gồm các bước:
Bước 1: Ứng dụng tạo dữ liệu telemetry
Khi ứng dụng tiếp nhận request, instrumentation tự động hoặc thủ công ghi nhận hoạt động như thời gian xử lý, truy vấn database, lỗi phát sinh và các chỉ số hiệu suất.
Bước 2: SDK tiếp nhận và xử lý dữ liệu
Dữ liệu được chuyển đến OpenTelemetry SDK. SDK quản lý các hoạt động như tạo span, tổng hợp metrics, áp dụng sampling và chuẩn bị dữ liệu để xuất đi.
Bước 3: Truyền dữ liệu qua OTLP
SDK gửi telemetry đến Collector hoặc backend tương thích thông qua OTLP/gRPC hay OTLP/HTTP.
Bước 4: Collector xử lý dữ liệu
Collector tiếp nhận dữ liệu qua Receivers, thực hiện các thao tác như batch, lọc, bổ sung thuộc tính hoặc sampling thông qua Processors, sau đó chuyển tiếp bằng Exporters.
Bước 5: Backend lưu trữ và hiển thị dữ liệu
Dữ liệu được chuyển đến hệ thống backend như Prometheus, Jaeger, Grafana hoặc nền tảng APM thương mại. Những công cụ này đảm nhiệm việc lưu trữ, truy vấn, phân tích, tạo cảnh báo và trực quan hóa dữ liệu theo chức năng của từng nền tảng.
Một yếu tố quan trọng xuyên suốt quá trình là Context Propagation. Khi một request đi từ dịch vụ A sang dịch vụ B, thông tin trace context được truyền qua giao tiếp HTTP, gRPC hoặc các cơ chế vận chuyển phù hợp. Nhờ đó, các span được liên kết thành một trace thống nhất thay vì xuất hiện như những hoạt động độc lập.
Cần lưu ý rằng đây là kiến trúc phổ biến, không phải quy trình bắt buộc duy nhất. Với hệ thống đơn giản, ứng dụng có thể xuất telemetry trực tiếp đến backend mà không cần triển khai Collector riêng.
OpenTelemetry khác gì Prometheus, Jaeger và APM thương mại?
OpenTelemetry, Prometheus, Jaeger và các nền tảng APM thương mại đều xuất hiện trong hệ sinh thái observability, nhưng chúng không đảm nhiệm cùng một vai trò.
OpenTelemetry tập trung vào việc chuẩn hóa instrumentation, tạo và vận chuyển dữ liệu telemetry. Trong khi đó, Prometheus và Jaeger là các hệ thống chuyên biệt phục vụ thu thập, lưu trữ hoặc truy vấn một số loại dữ liệu quan sát.
1. OpenTelemetry và Prometheus
Prometheus tập trung vào metrics, cung cấp cơ chế thu thập dữ liệu theo mô hình pull, hệ thống lưu trữ chuỗi thời gian và ngôn ngữ truy vấn PromQL.
OpenTelemetry có phạm vi rộng hơn khi hỗ trợ nhiều loại tín hiệu và cung cấp API, SDK để instrument ứng dụng.
Hai công cụ có thể phối hợp thông qua Prometheus Receiver hoặc Prometheus Remote Write Exporter trong OpenTelemetry Collector. Vì vậy, doanh nghiệp không nhất thiết phải chọn một trong hai.
2. OpenTelemetry và Jaeger
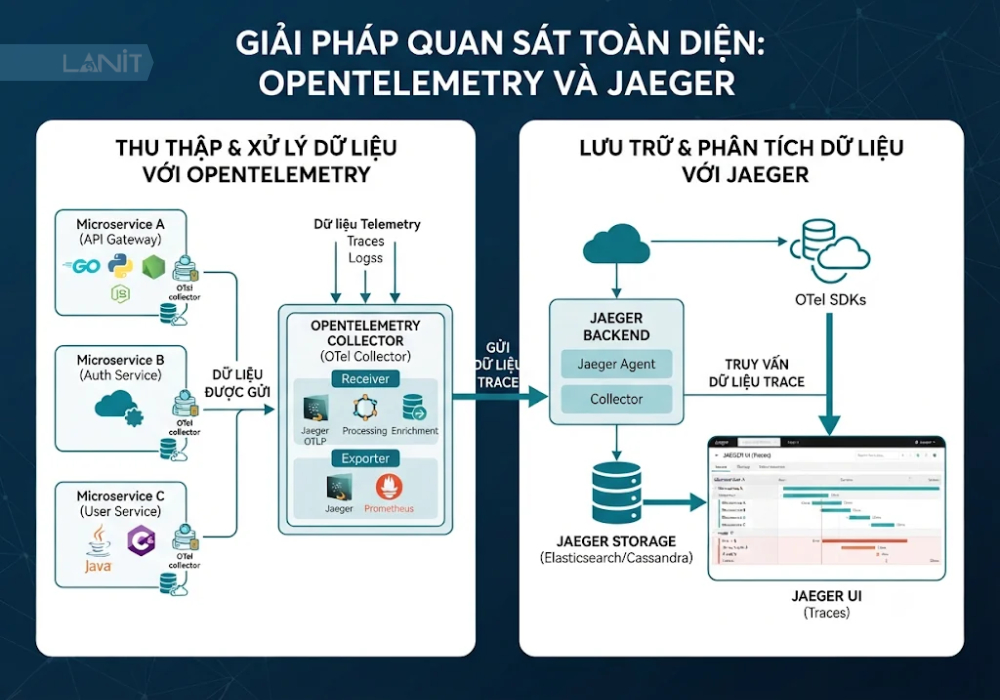
Jaeger là nền tảng mã nguồn mở chuyên về distributed tracing, hỗ trợ thu thập, lưu trữ và truy vấn các trace để phân tích request đi qua hệ thống phân tán.
OpenTelemetry cung cấp cơ chế tạo và xuất traces theo chuẩn chung. Jaeger có thể tiếp nhận dữ liệu OTLP để phục vụ việc phân tích và truy vấn.
Do đó, một kiến trúc phổ biến là sử dụng OpenTelemetry SDK và Collector để tạo, xử lý, vận chuyển trace, sau đó dùng Jaeger làm hệ thống backend tracing.
3. OpenTelemetry và APM thương mại
Các nền tảng APM thương mại thường cung cấp giải pháp observability tích hợp, bao gồm thu thập dữ liệu, phân tích hiệu suất, cảnh báo, dashboard và hỗ trợ điều tra sự cố.
OpenTelemetry không thay thế toàn bộ những chức năng này. Thay vào đó, nó giúp chuẩn hóa dữ liệu đầu vào và giảm sự phụ thuộc vào instrumentation độc quyền của từng nhà cung cấp.
Một số nền tảng APM hỗ trợ tiếp nhận OTLP trực tiếp hoặc thông qua Collector. Nhờ vậy, doanh nghiệp có thể sử dụng OpenTelemetry để instrument ứng dụng và lựa chọn backend phù hợp với nhu cầu vận hành.
Tóm lại: OpenTelemetry không phải đối thủ trực tiếp của Prometheus hay Jaeger. Đây là lớp tiêu chuẩn hóa dữ liệu telemetry có thể kết hợp với các công cụ này để xây dựng một hệ thống observability hoàn chỉnh.
Lợi ích và hạn chế khi sử dụng OpenTelemetry
OpenTelemetry mang lại nhiều lợi ích cho hoạt động giám sát ứng dụng, đặc biệt trong môi trường microservices và cloud-native. Tuy nhiên, việc triển khai cũng đòi hỏi kiến thức kỹ thuật, tài nguyên và quy trình quản lý dữ liệu phù hợp.
1. Lợi ích của OpenTelemetry
- Chuẩn hóa dữ liệu telemetry: Cung cấp tiêu chuẩn chung để tạo và xuất traces, metrics, logs giữa các ứng dụng và hệ thống khác nhau.
- Hạn chế vendor lock-in: Doanh nghiệp có thể thay đổi backend observability mà không nhất thiết phải viết lại toàn bộ instrumentation.
- Hỗ trợ nhiều ngôn ngữ: Cung cấp API, SDK và thư viện cho nhiều ngôn ngữ lập trình, phù hợp với hệ thống có nhiều công nghệ khác nhau.
- Liên kết các loại dữ liệu: Có thể kết nối traces, metrics và logs thông qua các thông tin định danh như Trace ID và Span ID, giúp điều tra sự cố thuận tiện hơn.
- Linh hoạt trong triển khai: Có thể chạy trực tiếp trong ứng dụng, sử dụng Collector tập trung hoặc kết hợp nhiều mô hình theo kiến trúc hệ thống.
- Hệ sinh thái phát triển: Được hỗ trợ bởi cộng đồng CNCF và nhiều nhà cung cấp observability, giúp doanh nghiệp có thêm lựa chọn khi xây dựng hệ thống giám sát.
2. Hạn chế của OpenTelemetry
- Đòi hỏi kiến thức kỹ thuật: Developer cần hiểu cách instrument, cấu hình SDK, Collector, pipeline và giao thức truyền dữ liệu.
- Tăng độ phức tạp vận hành: Khi triển khai trên nhiều dịch vụ, việc quản lý phiên bản SDK, cấu hình Collector và kiểm soát luồng dữ liệu có thể trở nên phức tạp.
- Phát sinh chi phí tài nguyên: Thu thập quá nhiều telemetry có thể làm tăng mức sử dụng CPU, RAM, network và dung lượng lưu trữ.
- Cần kiểm soát Cardinality: Metrics có quá nhiều thuộc tính với giá trị khác nhau có thể tạo ra số lượng time series lớn, ảnh hưởng đến hiệu suất và chi phí backend.
- Không cung cấp backend hoàn chỉnh: Doanh nghiệp vẫn cần hệ thống riêng để lưu trữ, truy vấn, trực quan hóa và cảnh báo dữ liệu.
- Có thể chưa cần thiết với hệ thống nhỏ: Website hoặc ứng dụng đơn giản chỉ có một vài dịch vụ có thể sử dụng công cụ giám sát nhẹ hơn thay vì xây dựng pipeline OpenTelemetry đầy đủ.
Vì vậy, OpenTelemetry phù hợp nhất khi doanh nghiệp cần chuẩn hóa dữ liệu quan sát trên nhiều dịch vụ, nhiều ngôn ngữ hoặc có kế hoạch mở rộng kiến trúc trong tương lai.
Cách triển khai OpenTelemetry trên Kubernetes và Cloud Server
OpenTelemetry có thể triển khai trên máy chủ riêng, Cloud Server hoặc cụm Kubernetes. Mô hình phù hợp phụ thuộc vào số lượng ứng dụng, lưu lượng telemetry, yêu cầu xử lý dữ liệu và khả năng vận hành của đội ngũ kỹ thuật.
1. Mô hình Agent và Gateway cho Collector
OpenTelemetry Collector hỗ trợ hai mô hình triển khai phổ biến là Agent và Gateway.
Agent là Collector chạy gần ứng dụng hoặc trên từng node hạ tầng. Trong Kubernetes, Agent thường được triển khai dưới dạng DaemonSet để mỗi node có một Collector tiếp nhận telemetry từ các Pod và thành phần chạy trên node đó.
Ưu điểm của mô hình này là dữ liệu được tiếp nhận gần nguồn phát sinh, giúp phân phối tải và hạn chế việc gửi quá nhiều kết nối trực tiếp đến Collector tập trung.
Gateway là Collector chạy như một dịch vụ độc lập, tiếp nhận dữ liệu từ nhiều Agent hoặc ứng dụng. Gateway có thể thực hiện batch, lọc, sampling, bổ sung metadata và chuyển tiếp dữ liệu đến backend.
Mô hình này phù hợp khi doanh nghiệp muốn tập trung quản lý pipeline telemetry, kiểm soát đầu ra và phân chia quyền truy cập giữa các thành phần.
Ngoài ra, Collector cũng có thể triển khai dưới dạng Sidecar, tức là một container chạy cùng Pod với ứng dụng. Cách này phù hợp khi mỗi workload cần cấu hình thu thập riêng, nhưng sẽ làm tăng số lượng Collector cần vận hành và mức tiêu thụ tài nguyên.
Trong thực tế, doanh nghiệp có thể kết hợp Agent và Gateway: Agent thu thập dữ liệu tại từng node, còn Gateway xử lý tập trung trước khi gửi đến backend.
2. Dùng OpenTelemetry Operator trên Kubernetes
OpenTelemetry Operator là công cụ giúp quản lý OpenTelemetry Collector và triển khai auto-instrumentation cho workload trong Kubernetes.
Thay vì tạo và quản lý từng Collector thủ công, người vận hành có thể khai báo cấu hình thông qua các Custom Resource Definition (CRD). Operator sẽ theo dõi những khai báo này và quản lý các tài nguyên Kubernetes tương ứng.
Quá trình triển khai cơ bản gồm:
- Cài đặt OpenTelemetry Operator vào Kubernetes cluster. Môi trường triển khai cần đáp ứng các yêu cầu phụ thuộc, trong đó có cert-manager theo hướng dẫn chính thức.
- Khai báo tài nguyên OpenTelemetryCollector để xác định cấu hình Receiver, Processor, Exporter và pipeline.
- Cấu hình auto-instrumentation cho các workload được hỗ trợ, lựa chọn ngôn ngữ và cách inject instrumentation phù hợp.
- Kiểm tra dữ liệu telemetry được gửi đến Collector và backend, đồng thời theo dõi trạng thái các Pod liên quan.
Operator giúp đơn giản hóa quá trình quản lý Collector và instrumentation trên Kubernetes. Tuy nhiên, công cụ này không thay thế việc thiết kế pipeline, quản lý tài nguyên hay cấu hình bảo mật.
>>>> Đọc thêm bài viết: Kubernetes là gì? Kiến trúc, cách hoạt động và ứng dụng thực tế
3. Hạ tầng chạy Collector và lưu trữ telemetry
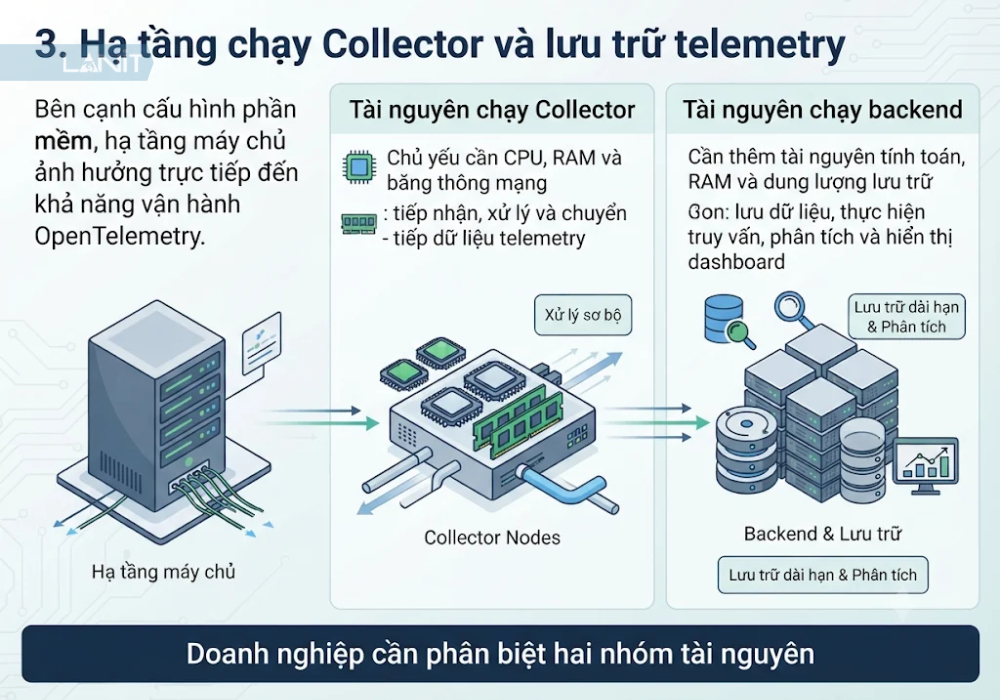
Bên cạnh cấu hình phần mềm, hạ tầng máy chủ ảnh hưởng trực tiếp đến khả năng vận hành OpenTelemetry.
Khi triển khai trên Cloud Server hoặc máy chủ riêng, doanh nghiệp cần phân biệt hai nhóm tài nguyên:
- Tài nguyên chạy Collector: Chủ yếu cần CPU, RAM và băng thông mạng để tiếp nhận, xử lý và chuyển tiếp dữ liệu telemetry.
- Tài nguyên chạy backend: Cần thêm tài nguyên tính toán, RAM và dung lượng lưu trữ để lưu dữ liệu, thực hiện truy vấn, phân tích và hiển thị dashboard.
Nếu chỉ chạy Collector và gửi dữ liệu đến nền tảng observability bên ngoài, yêu cầu tài nguyên máy chủ thường thấp hơn so với việc tự vận hành toàn bộ backend.
Khi thiết kế hạ tầng, cần chú ý một số yếu tố:
- Sampling: Không phải mọi trace đều cần được lưu trữ. Sampling giúp giảm lượng dữ liệu bằng cách lựa chọn một tỷ lệ trace phù hợp. Với hệ thống quan trọng, có thể sử dụng tail sampling để đưa ra quyết định sau khi đã quan sát các span của trace, chẳng hạn ưu tiên giữ lại trace có lỗi hoặc độ trễ cao.
- Retention: Xác định thời gian lưu trữ telemetry theo nhu cầu phân tích và điều tra sự cố. Không nhất thiết phải giữ toàn bộ dữ liệu trong thời gian dài vì điều này có thể làm tăng chi phí lưu trữ.
- Cardinality: Kiểm soát số lượng giá trị thuộc tính của metrics, tránh sử dụng các thông tin thay đổi liên tục như user ID hoặc request ID làm nhãn metrics có cardinality cao.
- Bảo mật: Cần cấu hình TLS khi truyền dữ liệu qua mạng, kiểm soát quyền truy cập Collector và backend, đồng thời lọc các thông tin nhạy cảm trước khi xuất telemetry. Logs và Baggage cần được kiểm tra kỹ để tránh làm lộ dữ liệu cá nhân hoặc thông tin xác thực.
- Khả năng mở rộng: Khi số lượng ứng dụng và request tăng lên, cần theo dõi mức sử dụng CPU, RAM, network của Collector để điều chỉnh số lượng instance, cấu hình batch và phân phối tải.
Với doanh nghiệp muốn tự quản lý Collector, backend observability hoặc các dịch vụ giám sát nội bộ, Cloud Server có thể cung cấp môi trường triển khai linh hoạt và chủ động phân bổ tài nguyên. LANIT hỗ trợ tư vấn cấu hình Cloud Server theo nhu cầu CPU, RAM, dung lượng lưu trữ và quy mô hệ thống, giúp doanh nghiệp lựa chọn hạ tầng phù hợp mà không phải đầu tư máy chủ vật lý ngay từ đầu.
Cách bắt đầu sử dụng OpenTelemetry
Không nhất thiết phải instrument toàn bộ hệ thống ngay từ đầu. Doanh nghiệp có thể triển khai OpenTelemetry theo từng giai đoạn để kiểm soát độ phức tạp, đánh giá hiệu quả và tối ưu tài nguyên.
Bước 1: Chọn dịch vụ thí điểm
Bắt đầu với một dịch vụ có lưu lượng đáng kể hoặc thường xuyên phát sinh vấn đề về hiệu suất. Ví dụ, có thể chọn API xử lý đơn hàng, dịch vụ thanh toán hoặc thành phần giao tiếp với database. Việc giới hạn phạm vi giúp đội ngũ kỹ thuật dễ kiểm tra dữ liệu và đánh giá kết quả.
Bước 2: Bật auto-instrumentation
Cài đặt SDK hoặc agent tương ứng với ngôn ngữ lập trình và framework đang sử dụng. Ưu tiên thu thập các dữ liệu cơ bản như request, độ trễ, lỗi và truy vấn database. Nếu cần theo dõi các hoạt động nghiệp vụ đặc thù, developer có thể bổ sung manual instrumentation.
Bước 3: Dựng OpenTelemetry Collector
Cấu hình Collector để tiếp nhận dữ liệu từ ứng dụng, xử lý bằng các Processor và chuyển tiếp đến backend. Ở giai đoạn đầu, có thể sử dụng cấu hình đơn giản với OTLP Receiver, Batch Processor và Exporter tương ứng. Khi lưu lượng tăng, tiếp tục bổ sung sampling, memory limiter và các chính sách lọc dữ liệu.
Bước 4: Kết nối backend và mở rộng
Kết nối Collector với hệ thống lưu trữ và trực quan hóa như Prometheus, Jaeger, Grafana hoặc nền tảng APM phù hợp. Kiểm tra khả năng liên kết traces, metrics và logs, sau đó đánh giá mức tiêu thụ tài nguyên và chi phí. Khi pipeline hoạt động ổn định, có thể mở rộng instrumentation sang các dịch vụ khác.
Cách tiếp cận từng bước giúp doanh nghiệp xây dựng hệ thống observability có kiểm soát, tránh thu thập quá nhiều dữ liệu ngay từ đầu và giảm áp lực vận hành.
Câu hỏi thường gặp về OpenTelemetry
OpenTelemetry (OTel) là gì và do tổ chức nào phát triển?
OpenTelemetry là framework mã nguồn mở dùng để tạo, thu thập và xuất dữ liệu telemetry. Dự án hình thành từ sự hợp nhất của OpenTracing và OpenCensus vào năm 2019, được phát triển trong hệ sinh thái CNCF.
OpenTelemetry có phải công cụ giám sát không?
OpenTelemetry hỗ trợ hoạt động observability bằng cách instrument ứng dụng, tạo và vận chuyển dữ liệu telemetry. Tuy nhiên, đây không phải nền tảng giám sát hoàn chỉnh vì không trực tiếp đảm nhiệm lưu trữ, truy vấn hay trực quan hóa dữ liệu. Doanh nghiệp cần kết hợp với backend như Prometheus, Jaeger hoặc các nền tảng APM.
OpenTelemetry có thay thế Prometheus không?
Không. OpenTelemetry và Prometheus có vai trò khác nhau. OpenTelemetry chuẩn hóa quá trình tạo và xuất nhiều loại dữ liệu telemetry, còn Prometheus tập trung vào thu thập, lưu trữ và truy vấn metrics. Hai công cụ có thể kết hợp trong cùng một hệ thống observability.
OpenTelemetry có miễn phí không?
OpenTelemetry là dự án mã nguồn mở và được sử dụng miễn phí theo giấy phép của các thành phần tương ứng. Tuy nhiên, doanh nghiệp vẫn có thể phát sinh chi phí cho máy chủ, lưu trữ telemetry, băng thông, vận hành backend hoặc sử dụng nền tảng APM thương mại.
OpenTelemetry hỗ trợ những ngôn ngữ lập trình nào?
OpenTelemetry có các triển khai API, SDK và instrumentation cho nhiều ngôn ngữ như Java, Python, JavaScript, Go, .NET, PHP, Ruby và một số ngôn ngữ khác. Tuy nhiên, mức độ hỗ trợ, tính năng và trạng thái ổn định có thể khác nhau giữa từng ngôn ngữ.
Hệ thống nhỏ có cần triển khai OpenTelemetry không?
Không phải hệ thống nhỏ nào cũng cần triển khai OpenTelemetry. Nếu ứng dụng chỉ có một dịch vụ và nhu cầu giám sát đơn giản, các công cụ monitoring cơ bản có thể đã đáp ứng đủ. OpenTelemetry phù hợp hơn khi cần chuẩn hóa telemetry, theo dõi nhiều dịch vụ hoặc có kế hoạch mở rộng hệ thống trong tương lai.
OpenTelemetry là nền tảng quan trọng trong hệ sinh thái observability hiện đại, giúp chuẩn hóa cách ứng dụng tạo, thu thập và xuất dữ liệu traces, metrics và logs. Với kiến trúc linh hoạt, khả năng tích hợp nhiều backend và hỗ trợ đa ngôn ngữ, công cụ này đặc biệt hữu ích cho hệ thống microservices và ứng dụng cloud-native.
Để triển khai OpenTelemetry hiệu quả, doanh nghiệp cần lựa chọn mô hình Collector phù hợp, kiểm soát lượng telemetry và chuẩn bị hạ tầng đủ khả năng xử lý dữ liệu. Nếu đang xây dựng hệ thống giám sát trên Cloud Server, bạn có thể liên hệ LANIT để được tư vấn cấu hình tài nguyên phù hợp với quy mô ứng dụng và nhu cầu vận hành.