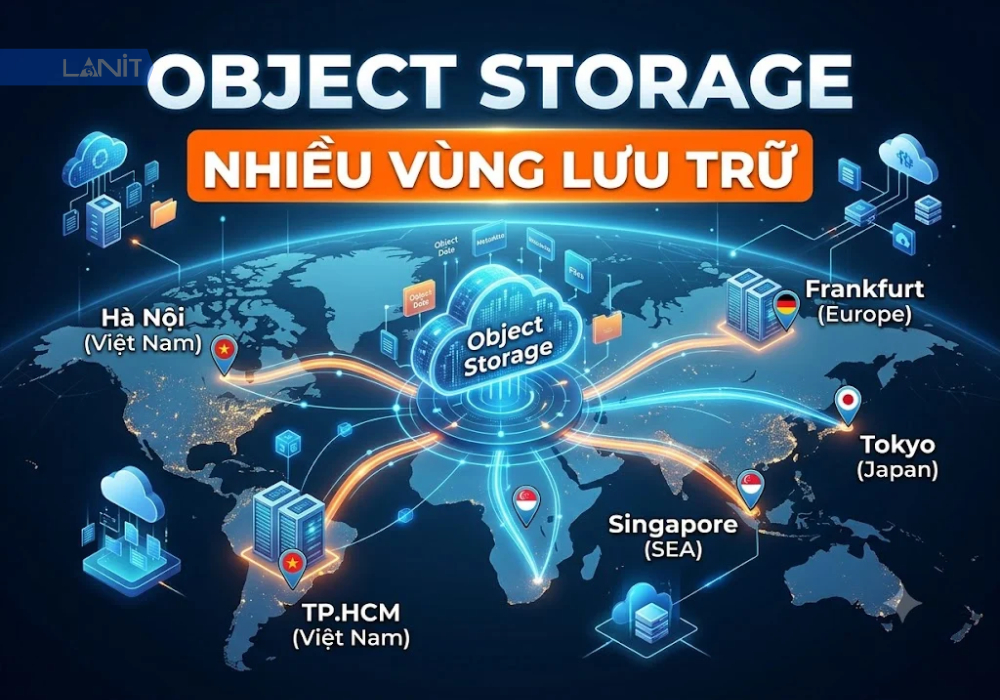
Khi một trung tâm dữ liệu gặp sự cố, dữ liệu được lưu tại đó có thể bị gián đoạn truy cập nếu không có cơ chế dự phòng phù hợp. Object Storage nhiều vùng lưu trữ giúp giảm rủi ro này bằng cách duy trì dữ liệu tại các vùng hạ tầng địa lý khác nhau. Tuy nhiên, hiệu quả bảo vệ dữ liệu còn phụ thuộc vào cơ chế nhân bản, độ trễ đồng bộ, khả năng chuyển đổi khi xảy ra sự cố và chi phí vận hành.
Object Storage nhiều vùng lưu trữ là gì?
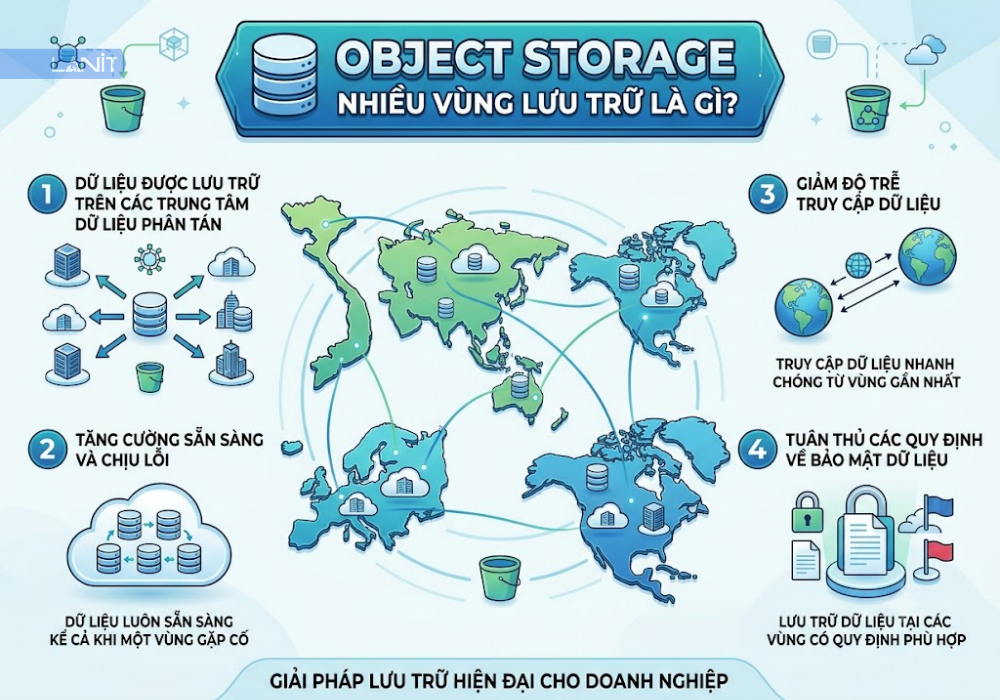
Object Storage nhiều vùng lưu trữ (Multi-region Object Storage) là mô hình lưu trữ trong đó dữ liệu được duy trì tại nhiều vùng địa lý hoặc miền hạ tầng khác nhau nhằm tăng khả năng chịu lỗi, hỗ trợ truy cập dữ liệu từ nhiều khu vực và cải thiện khả năng khôi phục sau sự cố.
Khác với việc chỉ lưu nhiều đối tượng trong cùng một bucket, mô hình này tập trung vào việc phân bố hoặc nhân bản dữ liệu giữa các vùng hạ tầng độc lập. Tuy nhiên, cách triển khai cụ thể phụ thuộc vào kiến trúc và tính năng của từng nhà cung cấp.
1. Region khác bucket và availability zone thế nào?
Ba thuật ngữ region, availability zone và bucket đại diện cho những khái niệm khác nhau trong kiến trúc lưu trữ đám mây.
- Region: Khu vực địa lý hoặc miền hạ tầng do nhà cung cấp xác định. Một region có thể bao gồm nhiều availability zone hoặc trung tâm dữ liệu.
- Availability Zone (AZ): Miền hạ tầng có mức độ độc lập nhất định trong một region, giúp giảm ảnh hưởng khi một phần hạ tầng gặp sự cố.
- Bucket: Không gian lưu trữ logic dùng để tổ chức và quản lý các đối tượng dữ liệu như hình ảnh, tài liệu, bản sao lưu và tệp ứng dụng.
Ví dụ, doanh nghiệp có thể tạo một bucket để lưu dữ liệu ứng dụng. Các đối tượng trong bucket có thể được lưu dự phòng giữa nhiều AZ trong cùng một region hoặc được nhân bản sang một region khác, tùy cơ chế của dịch vụ.
Do đó, tạo thêm bucket không đồng nghĩa với việc dữ liệu đã được lưu ở một vùng địa lý khác. Muốn xác định mức độ dự phòng thực tế, doanh nghiệp cần kiểm tra vị trí lưu trữ và chính sách nhân bản của nhà cung cấp.
2. Multi-region khác sao lưu thông thường ở điểm nào?
Multi-region và backup đều góp phần bảo vệ dữ liệu, nhưng giải quyết những rủi ro khác nhau.
Multi-region tập trung vào việc duy trì dữ liệu tại nhiều vùng hạ tầng, qua đó giảm sự phụ thuộc vào một vùng duy nhất. Backup tạo ra bản sao phục vụ khôi phục khi dữ liệu bị xóa, ghi đè, hỏng hoặc bị ảnh hưởng bởi sự cố bảo mật.
Điểm khác biệt quan trọng là nhân bản không nhất thiết tạo ra một bản sao độc lập có thể khôi phục về trạng thái trước đó. Nếu dữ liệu bị xóa nhầm hoặc nội dung sai được nhân bản sang vùng khác, bản sao cũng có thể chịu ảnh hưởng.
Vì vậy, doanh nghiệp nên xem lưu trữ nhiều vùng và backup là hai lớp bảo vệ bổ sung cho nhau. Khi xây dựng phương án bảo vệ dữ liệu, cần xác định cả khả năng chịu lỗi hạ tầng lẫn khả năng khôi phục dữ liệu về một thời điểm phù hợp.
Dữ liệu được nhân bản giữa các vùng như thế nào?
Nhân bản liên vùng là quá trình sao chép đối tượng dữ liệu từ vùng nguồn sang một hoặc nhiều vùng đích theo chính sách được cấu hình. Cơ chế này có thể hoạt động đồng bộ hoặc bất đồng bộ, theo một chiều hoặc hai chiều.
Cách nhân bản ảnh hưởng trực tiếp đến độ trễ ghi, tính nhất quán của dữ liệu, khả năng khôi phục và mức độ phức tạp khi vận hành.
1. Nhân bản đồng bộ và bất đồng bộ khác nhau ra sao?
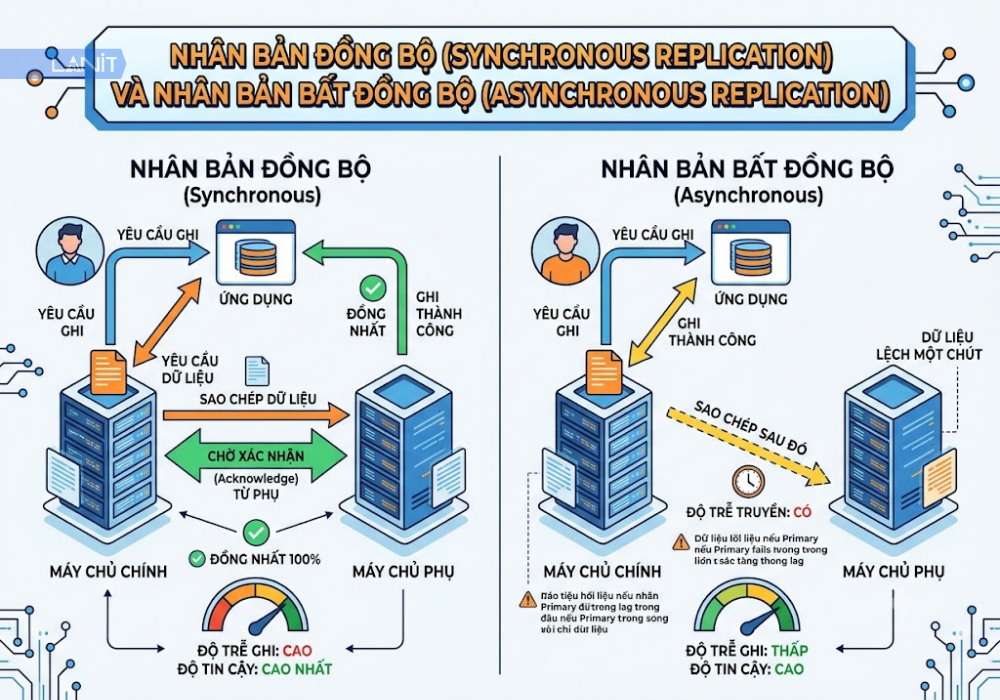
Nhân bản đồng bộ và bất đồng bộ khác nhau chủ yếu ở thời điểm hệ thống xác nhận thao tác ghi dữ liệu so với quá trình lưu bản sao tại vùng đích.
- Nhân bản đồng bộ (Synchronous Replication) yêu cầu các điều kiện xác nhận ghi dữ liệu được đáp ứng tại những vị trí theo thiết kế trước khi thao tác được xác nhận thành công. Cơ chế này có thể giảm khoảng thời gian dữ liệu chưa được lưu tại vị trí dự phòng, nhưng thường làm tăng độ trễ ghi khi các vùng cách xa nhau.
- Nhân bản bất đồng bộ (Asynchronous Replication) cho phép hệ thống xác nhận ghi tại vùng nguồn trước khi hoàn tất việc sao chép sang vùng đích. Cách này giúp giảm ảnh hưởng của độ trễ liên vùng đến thao tác ghi, nhưng có thể tạo ra một khoảng thời gian mà dữ liệu ở các vùng chưa hoàn toàn giống nhau.
| Tiêu chí | Nhân bản đồng bộ | Nhân bản bất đồng bộ |
| Thời điểm xác nhận ghi | Theo điều kiện xác nhận của các vị trí tham gia | Có thể xác nhận trước khi bản sao ở vùng đích hoàn tất |
| Độ trễ ghi | Có thể cao hơn do phải chờ xác nhận | Thường ít phụ thuộc hơn vào thời gian truyền liên vùng |
| Độ trễ đồng bộ | Bản sao được cập nhật theo quy trình đồng bộ | Có thể tồn tại độ trễ giữa các vùng |
| Rủi ro khi vùng nguồn gặp sự cố | Phụ thuộc vào phạm vi xác nhận ghi và kiến trúc | Có thể mất các thay đổi chưa được nhân bản |
| Phù hợp với | Hệ thống cần kiểm soát chặt trạng thái ghi và chấp nhận độ trễ tương ứng | Hệ thống cần mở rộng địa lý và chấp nhận độ trễ nhân bản |
Không phải dịch vụ thuê S3 Object Storage giá rẻ nào cũng cung cấp cả hai cơ chế. Doanh nghiệp cần kiểm tra tài liệu kỹ thuật để xác định cách xác nhận ghi và bảo đảm dữ liệu của dịch vụ đang sử dụng.
2. Nhân bản một chiều và hai chiều dùng khi nào?
Nhân bản một chiều và hai chiều khác nhau ở hướng dữ liệu được sao chép giữa các vùng.
- Nhân bản một chiều (One-way Replication) sao chép dữ liệu từ vùng nguồn sang vùng đích. Mô hình này phù hợp khi doanh nghiệp muốn duy trì một bản sao dự phòng, sao chép dữ liệu phục vụ phân tích hoặc phân phối nội dung đến khu vực khác.
- Nhân bản hai chiều (Two-way Replication) cho phép dữ liệu được nhân bản theo cả hai hướng giữa các vùng. Mô hình này có thể phù hợp với hệ thống cần cập nhật dữ liệu ở nhiều khu vực hoặc cần duy trì bản sao sau khi chuyển hoạt động sang vùng dự phòng.
Tuy nhiên, nhân bản hai chiều không tự động giải quyết xung đột. Nếu cùng một đối tượng được sửa đổi ở cả hai vùng, hệ thống cần có quy tắc xác định phiên bản hợp lệ, xử lý thay đổi đồng thời và đồng bộ metadata nếu cần.
Do đó, doanh nghiệp không nên lựa chọn mô hình hai chiều chỉ vì muốn tăng khả năng sẵn sàng. Quyết định cần dựa trên cách ứng dụng đọc, ghi dữ liệu và khả năng xử lý xung đột của hệ thống.
3. Độ trễ nhân bản ảnh hưởng gì đến tính nhất quán của dữ liệu?
Độ trễ nhân bản là khoảng thời gian từ khi dữ liệu được ghi tại vùng nguồn đến khi bản sao tương ứng được cập nhật tại vùng đích.
Trong thời gian này, ứng dụng đọc dữ liệu ở hai vùng có thể nhận được các phiên bản khác nhau nếu cơ chế truy cập và tính nhất quán của dịch vụ cho phép. Điều này đặc biệt quan trọng với dữ liệu thường xuyên thay đổi như trạng thái đơn hàng, tệp cấu hình hoặc dữ liệu nghiệp vụ.
Ví dụ, một ứng dụng ghi trạng thái đơn hàng tại Hà Nội rồi đọc dữ liệu ngay tại vùng TP.HCM. Nếu quá trình nhân bản chưa hoàn tất và dịch vụ không bảo đảm đọc được bản ghi mới nhất từ vùng đích, ứng dụng có thể nhận trạng thái cũ.
Để hạn chế rủi ro, doanh nghiệp cần:
- Xác định độ trễ nhân bản mục tiêu phù hợp với yêu cầu nghiệp vụ.
- Kiểm tra khả năng giám sát trạng thái và phát hiện bản sao chưa đồng bộ.
- Thiết kế ứng dụng để xử lý dữ liệu chưa cập nhật hoặc lỗi truy cập vùng.
- Kiểm thử quá trình chuyển đổi và đối soát dữ liệu khi xảy ra sự cố.
Nhân bản nhanh hơn có thể giảm khoảng thời gian phơi nhiễm trước sự cố, nhưng không nên mặc định rằng dữ liệu giữa các vùng luôn đồng nhất tại mọi thời điểm.
Khi nào doanh nghiệp cần lưu trữ nhiều vùng?
Doanh nghiệp nên cân nhắc Object Storage nhiều vùng khi cần giảm sự phụ thuộc vào một vùng hạ tầng, phục vụ dữ liệu ở nhiều khu vực hoặc đáp ứng yêu cầu về vị trí lưu trữ. Tuy nhiên, hiệu quả thực tế phụ thuộc vào cách tổ chức dữ liệu, ứng dụng và cơ chế khôi phục.
1. Chịu được sự cố cấp vùng như thế nào?
Nếu dữ liệu chỉ được lưu trong một vùng, sự cố diện rộng tại vùng đó có thể khiến ứng dụng không truy cập được dữ liệu trong một khoảng thời gian. Trong trường hợp nghiêm trọng, dữ liệu còn có nguy cơ bị ảnh hưởng nếu không có cơ chế dự phòng phù hợp.
Duy trì bản sao tại một vùng địa lý khác giúp giảm sự phụ thuộc này. Khi vùng chính gặp sự cố, hệ thống có thể tiếp tục phục vụ dữ liệu từ vùng còn lại nếu kiến trúc lưu trữ và ứng dụng hỗ trợ.
Tuy nhiên, có bản sao chưa đồng nghĩa với việc dịch vụ sẽ tự động chuyển đổi. Doanh nghiệp cần xác định cách phát hiện sự cố, chuyển hướng truy cập, xử lý dữ liệu chưa nhân bản và khôi phục hoạt động.
Đối với hệ thống quan trọng, nên kiểm thử kịch bản mất kết nối vùng, gián đoạn dịch vụ và phục hồi sau sự cố thay vì chỉ dựa vào mô tả về khả năng dự phòng của nhà cung cấp.
2. Khi nào nhiều vùng giúp giảm độ trễ cho người dùng?
Lưu trữ dữ liệu tại nhiều vùng có thể giúp giảm độ trễ truy cập nếu ứng dụng phục vụ người dùng ở nhiều khu vực địa lý và có thể đọc dữ liệu từ vùng phù hợp.
Ví dụ, doanh nghiệp có người dùng tại cả miền Bắc và miền Nam có thể cân nhắc bố trí dữ liệu ở những vị trí gần hệ thống xử lý hoặc người dùng. Khi đó, việc truy cập tệp có khả năng nhanh hơn so với trường hợp mọi yêu cầu đều phải đi đến một vùng ở xa.
Tuy nhiên, lợi ích này không tự động xuất hiện chỉ vì dữ liệu có nhiều bản sao. Hệ thống cần hỗ trợ định tuyến yêu cầu, lựa chọn vùng phục vụ và xử lý các bản sao chưa đồng bộ.
Ngoài ra, độ trễ còn phụ thuộc vào mạng, dung lượng tệp, tải hệ thống và vị trí của ứng dụng xử lý dữ liệu. Doanh nghiệp nên đo kiểm trong điều kiện thực tế trước khi quyết định phân bố dữ liệu.
3. Lưu trữ nhiều vùng có đáp ứng yêu cầu vị trí địa lý không?
Object Storage nhiều vùng có thể hỗ trợ doanh nghiệp phân bố dữ liệu theo các khu vực địa lý được lựa chọn, nhưng không tự động bảo đảm đáp ứng mọi yêu cầu pháp lý về lưu trữ dữ liệu.
Khi cần kiểm soát vị trí dữ liệu, doanh nghiệp nên xác minh:
- Vị trí lưu dữ liệu gốc và các bản sao.
- Cơ chế nhân bản có đưa dữ liệu ra ngoài khu vực đã lựa chọn hay không.
- Vị trí lưu metadata, bản sao lưu và dữ liệu phát sinh từ quá trình xử lý.
- Khả năng kiểm soát, truy xuất thông tin về nơi lưu trữ theo yêu cầu vận hành.
Yêu cầu cụ thể còn phụ thuộc loại dữ liệu, ngành nghề và quy định áp dụng. Doanh nghiệp cần đối chiếu với chính sách dữ liệu và yêu cầu pháp lý liên quan thay vì chỉ dựa vào tên region của dịch vụ.
Chi phí và đánh đổi khi dùng nhiều vùng
Object Storage nhiều vùng có thể tăng chi phí so với lưu trữ một vùng do phát sinh thêm dung lượng bản sao, truyền dữ liệu liên vùng và hoạt động vận hành. Đổi lại, doanh nghiệp có thể cải thiện khả năng chịu lỗi và đáp ứng nhu cầu truy cập ở nhiều khu vực.
1. Một vùng và nhiều vùng khác nhau ở những điểm nào?
Bảng dưới đây so sánh mô hình một vùng với mô hình duy trì bản sao tại nhiều vùng địa lý.
| Tiêu chí | Một vùng | Nhiều vùng |
| Khả năng chịu lỗi cấp vùng | Phụ thuộc cơ chế dự phòng bên trong vùng | Có thể giảm rủi ro khi một vùng gặp sự cố |
| Dung lượng | Thấp hơn nếu chỉ lưu một bản dữ liệu | Có thể tăng theo số bản sao được duy trì |
| Băng thông nhân bản | Không phát sinh nhân bản liên vùng | Có thể phát sinh lưu lượng nhân bản |
| Độ trễ ghi | Thường đơn giản hơn khi ghi trong cùng vùng | Phụ thuộc mô hình đồng bộ và kiến trúc dịch vụ |
| Độ phức tạp vận hành | Thường thấp hơn | Cần quản lý trạng thái bản sao và quy trình khôi phục |
Cần lưu ý rằng lưu trữ một vùng không đồng nghĩa chỉ có một bản dữ liệu vật lý. Nhà cung cấp vẫn có thể duy trì dự phòng giữa các thiết bị hoặc AZ trong cùng vùng. Ngược lại, lưu trữ nhiều vùng cũng không mặc định bảo đảm tự động failover.
Chi phí và mức độ bảo vệ thực tế cần được đánh giá theo cấu hình cụ thể của dịch vụ.
2. Cách ước tính chi phí Object Storage nhiều vùng
Để ước tính chi phí, doanh nghiệp nên tách dung lượng lưu trữ khỏi các khoản phí phát sinh trong quá trình nhân bản và vận hành.
Các thành phần cần xem xét gồm:
- Dung lượng dữ liệu gốc và dung lượng các bản sao.
- Đơn giá lưu trữ tại từng vùng.
- Lưu lượng truyền dữ liệu để nhân bản giữa các vùng.
- Phí yêu cầu API, truy xuất dữ liệu hoặc truyền dữ liệu ra ngoài, nếu có.
- Chi phí giám sát, kiểm thử khôi phục và vận hành hệ thống.
Ví dụ minh họa: Một doanh nghiệp có 1 TB dữ liệu và muốn duy trì một bản sao đầy đủ tại vùng thứ hai. Giả sử hai vùng đều lưu toàn bộ dữ liệu, không tính nén hoặc khử trùng lặp.
Khi đó:
- Dung lượng dữ liệu gốc: 1 TB.
- Dung lượng bản sao tại vùng thứ hai: 1 TB.
- Tổng dung lượng lưu trữ logic: 2 TB.
Nếu hai vùng có cùng đơn giá và nhà cung cấp tính phí theo dung lượng thực tế lưu tại mỗi vùng, chi phí lưu trữ có thể gần gấp đôi phần lưu trữ dữ liệu gốc. Tuy nhiên, tổng hóa đơn không nhất thiết tăng đúng gấp đôi vì còn phụ thuộc đơn giá từng vùng, phí nhân bản, lưu lượng truy cập và chính sách tính phí của dịch vụ.
Ví dụ này chỉ minh họa cách tính, không phải báo giá của LANIT hay bất kỳ nhà cung cấp cụ thể nào.
Để tránh phát sinh chi phí ngoài dự kiến, doanh nghiệp nên lập bảng dự toán theo dung lượng hiện tại, tốc độ tăng dữ liệu, tần suất cập nhật và lượng dữ liệu cần truy cập từ mỗi vùng. Việc này giúp so sánh tổng chi phí sở hữu với mức độ rủi ro mà hệ thống cần giảm thiểu.
Failover và failback hoạt động thế nào?
Failover và failback là hai quy trình quan trọng khi xây dựng phương án khôi phục sau sự cố giữa các vùng. Failover chuyển hoạt động sang vùng dự phòng; failback đưa hoạt động trở về vùng ban đầu khi điều kiện vận hành đã đáp ứng.
1. Failover diễn ra thế nào khi một vùng gặp sự cố?
Failover là quá trình chuyển hướng hoạt động từ vùng chính sang vùng dự phòng khi vùng chính không còn đáp ứng yêu cầu vận hành.
Một quy trình failover thường gồm các bước:
- Phát hiện sự cố: Hệ thống giám sát xác định vùng chính không thể phục vụ yêu cầu hoặc không còn đáp ứng điều kiện hoạt động.
- Đánh giá khả năng chuyển đổi: Xác định vùng dự phòng có sẵn dữ liệu cần thiết và đủ điều kiện phục vụ hay không.
- Chuyển hướng truy cập: Điều chỉnh endpoint, định tuyến hoặc cấu hình ứng dụng theo kiến trúc đã thiết kế.
- Tiếp tục phục vụ: Ứng dụng đọc hoặc ghi dữ liệu tại vùng dự phòng theo chính sách vận hành.
- Kiểm tra tính toàn vẹn: Đánh giá dữ liệu chưa được nhân bản và xử lý các thay đổi phát sinh trong thời gian gián đoạn.
Tùy dịch vụ, failover có thể được thực hiện tự động hoặc cần thao tác của người vận hành. Nếu nhân bản bất đồng bộ, một số dữ liệu mới nhất có thể chưa xuất hiện ở vùng dự phòng tại thời điểm chuyển đổi.
Vì vậy, cần xác định trước RPO (Recovery Point Objective) và RTO (Recovery Time Objective). RPO thể hiện mức mất dữ liệu tối đa có thể chấp nhận; RTO thể hiện thời gian mục tiêu để khôi phục dịch vụ.
2. Failback đưa hoạt động về vùng ban đầu ra sao?
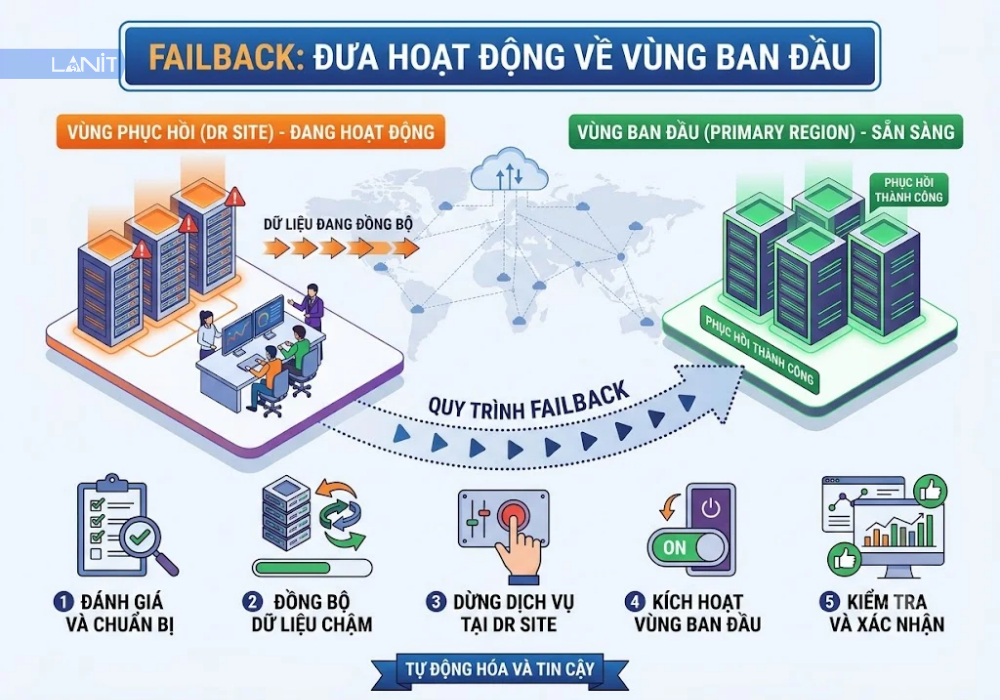
Failback là quá trình đưa hệ thống trở về vùng ban đầu sau khi sự cố được khắc phục và vùng đó đủ điều kiện hoạt động trở lại.
Trước khi chuyển về, doanh nghiệp cần kiểm tra tình trạng hạ tầng, xác định vùng đang nắm giữ dữ liệu mới nhất và đồng bộ những thay đổi phát sinh trong thời gian failover. Nếu cả hai vùng từng nhận ghi, cần xử lý xung đột và xác định trạng thái dữ liệu hợp lệ trước khi chuyển hướng.
Sau khi xác nhận dữ liệu đã được đồng bộ theo chính sách và vùng ban đầu đáp ứng yêu cầu vận hành, hệ thống mới thực hiện chuyển đổi lưu lượng trở lại. Cuối cùng, cần kiểm tra hoạt động đọc, ghi và giám sát để bảo đảm dịch vụ ổn định.
Failback không đơn giản là đảo ngược thao tác failover. Nếu không có quy trình đối soát và đồng bộ phù hợp, việc chuyển về có thể khiến ứng dụng sử dụng dữ liệu cũ hoặc tạo ra các phiên bản không nhất quán.
Cách chọn số vùng và cặp vùng phù hợp
Doanh nghiệp nên chọn số vùng dựa trên mức độ quan trọng của dữ liệu, rủi ro cần giảm thiểu và ngân sách. Không phải hệ thống nào cũng cần nhiều hơn hai vùng; điều quan trọng là phương án dự phòng đáp ứng được mục tiêu khôi phục thực tế.
Trước khi lựa chọn, hãy xem xét năm tiêu chí sau:
- Khoảng cách địa lý: Các vùng cần đủ độc lập để giảm nguy cơ cùng chịu ảnh hưởng từ một sự cố. Khoảng cách phù hợp phụ thuộc vào mô hình rủi ro và hạ tầng của nhà cung cấp.
- Vị trí người dùng và hệ thống xử lý: Ưu tiên vùng gần nơi phát sinh yêu cầu truy cập hoặc nơi ứng dụng xử lý dữ liệu, đồng thời kiểm tra khả năng định tuyến và tính nhất quán.
- RPO và RTO: Xác định mức mất dữ liệu và thời gian gián đoạn tối đa có thể chấp nhận. Hai chỉ số này giúp quyết định mô hình nhân bản và phương án khôi phục.
- Ngân sách: Tính cả dung lượng bản sao, phí truyền dữ liệu, truy cập và vận hành. Không nên chỉ so sánh đơn giá lưu trữ trên mỗi GB.
- Khả năng tương thích của API và công cụ nhân bản: Kiểm tra API S3, quyền truy cập, metadata, versioning và khả năng xử lý lỗi. Tương thích S3 không có nghĩa mọi tính năng nâng cao đều giống nhau giữa các nhà cung cấp.
Với dữ liệu ít quan trọng hoặc có thể tái tạo, một vùng kết hợp cơ chế dự phòng phù hợp có thể đã đủ. Với dữ liệu nghiệp vụ quan trọng, doanh nghiệp nên cân nhắc vùng dự phòng địa lý và kiểm thử khả năng khôi phục. Các hệ thống yêu cầu hoạt động liên tục ở nhiều khu vực có thể cần kiến trúc phức tạp hơn, bao gồm định tuyến, xử lý dữ liệu và kiểm soát xung đột.
Quyết định cuối cùng nên dựa trên kết quả đánh giá rủi ro và kiểm thử thực tế, không chỉ dựa vào số lượng vùng lưu trữ.
Câu hỏi thường gặp về Object Storage nhiều vùng lưu trữ
Multi-region khác gì sao lưu sang bucket khác?
Multi-region tập trung vào việc duy trì dữ liệu ở nhiều vùng hạ tầng địa lý, trong khi sao lưu sang bucket khác chỉ mô tả việc tạo bản sao tại một bucket khác. Hai bucket có thể vẫn nằm trong cùng một vùng. Muốn đánh giá mức độ dự phòng, cần kiểm tra vị trí thực tế và cơ chế nhân bản.
Nhân bản nhiều vùng có làm tăng gấp đôi chi phí không?
Không phải lúc nào tổng chi phí cũng tăng chính xác gấp đôi. Nếu mỗi vùng lưu một bản đầy đủ và có cùng đơn giá, riêng chi phí lưu trữ có thể gần gấp đôi. Tổng chi phí còn phụ thuộc phí nhân bản, truyền dữ liệu, truy cập và chính sách tính phí của nhà cung cấp.
Dữ liệu ở hai vùng có luôn giống hệt nhau không?
Không nhất thiết. Với nhân bản bất đồng bộ, dữ liệu tại vùng đích có thể chưa được cập nhật ngay sau khi vùng nguồn nhận thao tác ghi. Mức độ nhất quán phụ thuộc vào kiến trúc dịch vụ, cơ chế nhân bản và cách ứng dụng truy cập dữ liệu.
Khi một vùng gặp sự cố, ứng dụng có tự chuyển sang vùng còn lại không?
Chỉ khi dịch vụ và kiến trúc ứng dụng hỗ trợ cơ chế chuyển đổi tương ứng. Một số hệ thống có thể tự động định tuyến sang vùng khả dụng; hệ thống khác cần điều chỉnh endpoint hoặc thực hiện quy trình khôi phục thủ công. Doanh nghiệp cần kiểm tra và thử nghiệm trước khi đưa vào vận hành.
Doanh nghiệp nhỏ có cần lưu trữ nhiều vùng không?
Không phải doanh nghiệp nhỏ nào cũng cần nhiều vùng. Nếu dữ liệu có thể khôi phục dễ dàng và thời gian gián đoạn được chấp nhận, một vùng kết hợp backup phù hợp có thể đáp ứng nhu cầu. Nhiều vùng đáng cân nhắc hơn khi dữ liệu quan trọng, yêu cầu phục hồi nghiêm ngặt hoặc hoạt động kinh doanh phụ thuộc lớn vào khả năng truy cập dữ liệu liên tục.
Khi triển khai Object Storage nhiều vùng, ứng dụng cần thay đổi những gì?
Điều này phụ thuộc cách dịch vụ cung cấp quyền truy cập và cách ứng dụng sử dụng dữ liệu. Nếu có endpoint chung và cơ chế chuyển đổi được quản lý bởi dịch vụ, thay đổi ứng dụng có thể ít hơn. Nếu sử dụng các bucket riêng ở từng vùng, doanh nghiệp có thể cần cấu hình endpoint, định tuyến, quyền truy cập, xử lý lỗi và kiểm soát dữ liệu chưa đồng bộ.
Object Storage nhiều vùng lưu trữ giúp doanh nghiệp giảm sự phụ thuộc vào một vùng hạ tầng, nhưng hiệu quả bảo vệ dữ liệu phụ thuộc vào cơ chế nhân bản, tính nhất quán, khả năng khôi phục và cách ứng dụng vận hành.
Khi lựa chọn giải pháp, doanh nghiệp nên xác định RPO/RTO, đánh giá vị trí các vùng, tính toán tổng chi phí và kiểm thử failover/failback trước khi triển khai. Đồng thời, cần kết hợp nhân bản liên vùng với cơ chế backup phù hợp để xử lý cả sự cố hạ tầng lẫn lỗi dữ liệu.