Log hệ thống tăng đều mỗi ngày, chiếm dung lượng ổ đĩa và có thể ảnh hưởng đến hoạt động của server nếu không được quản lý tốt. Một giải pháp là xoay vòng, nén log cũ rồi chuyển lên dịch vụ thuê S3 Object Storage để lưu trữ dài hạn, giúp giảm dung lượng lưu trữ trên server mà vẫn giữ dữ liệu phục vụ truy vết và kiểm toán. Bài viết sẽ hướng dẫn cách triển khai luồng lưu log này, từ upload, tổ chức object đến quản lý vòng đời, truy xuất và bảo vệ dữ liệu.
Object Storage lưu log hệ thống là gì?
Object Storage lưu log hệ thống là cách sử dụng kho lưu trữ đối tượng để lưu dài hạn các file log đã được xoay vòng và nén, thay vì giữ toàn bộ log trên ổ đĩa của server. Mỗi file log được lưu thành một object trong bucket, có key riêng để xác định và truy xuất dữ liệu thông qua API tương thích S3. Server vẫn ghi log bình thường; chỉ những file đã hoàn tất ghi và sẵn sàng lưu trữ mới được chuyển lên Object Storage.
>>>> Đọc thêm bài viết: Object Storage hoạt động như thế nào?
Vì sao nên lưu log hệ thống trên Object Storage?
Log hợp với Object Storage vì ba lý do: dung lượng tăng liên tục, kiểu truy cập ghi một lần đọc rất ít, và chi phí lưu trữ thường thấp hơn so với dùng ổ đĩa của server.
1. Log tăng liên tục và gây áp lực lên ổ đĩa
Web server ghi từng request, ứng dụng ghi từng lỗi, hệ điều hành ghi từng lần đăng nhập. Khi ổ đĩa đầy, ứng dụng có thể ngừng ghi log hoặc lỗi theo cả database. Nhiều đội vận hành xử lý bằng cách xóa log cũ, nhưng đổi lại là mất dấu vết khi cần điều tra.
Theo báo cáo Cost of a Data Breach 2025 của IBM, trung bình mất 181 ngày để phát hiện và thêm 60 ngày để xử lý một vụ rò rỉ dữ liệu, tổng cộng 241 ngày. Nếu log chỉ được giữ 30 ngày, phần dấu vết ban đầu của sự cố đã không còn khi bạn cần đến.
Ngay cả hướng dẫn quản lý log NIST SP 800-92 cũng nhấn mạnh rằng bản ghi bảo mật phải được lưu đủ chi tiết trong một khoảng thời gian phù hợp. Giữ log lâu mà không đầy ổ đĩa chính là bài toán mà Object Storage giải quyết.
2. Log lưu dài hạn là dữ liệu ghi một lần, đọc rất ít
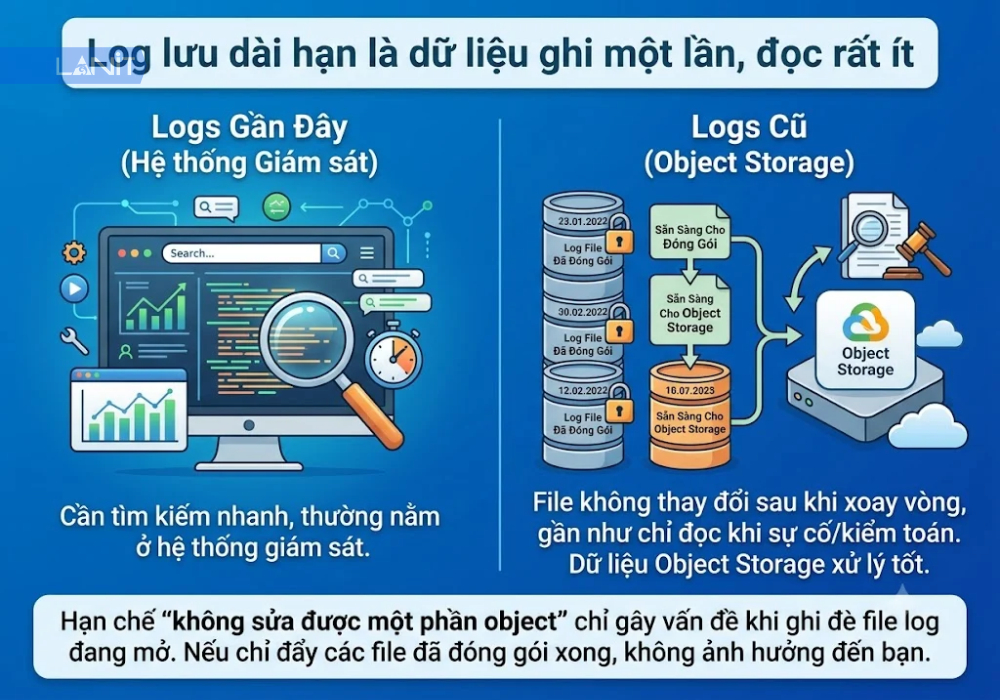
Log gần đây cần được tìm kiếm nhanh, nên thường nằm ở hệ thống giám sát. Log cũ thì khác: sau khi xoay vòng, file không còn thay đổi và gần như chỉ được đọc khi có sự cố hoặc kiểm toán. Đây đúng là kiểu dữ liệu Object Storage xử lý tốt.
Hạn chế “không sửa được một phần object” chỉ gây vấn đề khi ghi đè lên file log đang mở. Nếu chỉ đẩy các file đã đóng gói xong, hạn chế này không ảnh hưởng đến bạn.
3. So sánh với ổ đĩa server và Block Storage
Ba lựa chọn này phục vụ ba mục đích khác nhau, nên cần phân vai rõ ràng.
| Tiêu chí | Ổ đĩa server | Block Storage | Object Storage |
| Cách gắn | Gắn liền với một server | Gắn như ổ đĩa vào server | Truy cập qua API, không cần gắn |
| Mở rộng dung lượng | Phải nâng cấp server | Mở rộng theo từng volume | Gần như không giới hạn |
| Khi server gặp sự cố | Log có thể mất theo | Phụ thuộc cách cấu hình | Log vẫn nằm độc lập |
| Phù hợp với log | Log đang được ghi | Log cần đọc ghi thường xuyên | Log đã đóng gói, lưu dài hạn |
Khuyến nghị: để log đang ghi trên ổ đĩa server, đẩy log đã đóng gói sang Object Storage. Block Storage phù hợp hơn khi bạn cần một ổ đĩa gắn trực tiếp để chạy ứng dụng hoặc database.
Những loại log nên lưu trên Object Storage
Không phải loại log nào cũng cần lưu giữ trong cùng một khoảng thời gian. Việc lựa chọn nên dựa trên mục đích sử dụng, tần suất truy xuất và yêu cầu bảo mật của từng nhóm dữ liệu.
| Loại log | Ví dụ | Giá trị khi lưu dài hạn | Lưu ý |
| Log web server | Access log, error log của Nginx, Apache | Phân tích lưu lượng, truy vết request và điều tra truy cập bất thường | Thường phát sinh nhiều dữ liệu, có thể nén để giảm dung lượng lưu trữ |
| Log ứng dụng | Log lỗi, log nghiệp vụ | Truy vết lỗi theo thời điểm, phiên bản và hoạt động của ứng dụng | Tránh ghi mật khẩu, token và thông tin nhạy cảm vào log |
| Log database | Error log, slow query log | Điều tra lỗi truy vấn và phân tích hiệu năng theo thời gian | Cần kiểm soát dữ liệu nhạy cảm có thể xuất hiện trong câu truy vấn |
| Log bảo mật và audit | Log đăng nhập, SSH, sudo và thay đổi quyền | Điều tra sự cố bảo mật, kiểm toán và đối soát hoạt động | Nên hạn chế quyền sửa, xóa; cân nhắc Versioning hoặc Object Lock khi cần bảo toàn dữ liệu |
| Log hệ điều hành | Syslog, systemd journal | Điều tra lỗi dịch vụ, kernel và chẩn đoán sự cố hệ thống | Cần đồng bộ thời gian giữa các server để đối chiếu sự kiện chính xác |
Với log cần tìm kiếm, cảnh báo hoặc phân tích ngay khi phát sinh, nên tiếp tục sử dụng hệ thống giám sát log chuyên dụng. Object Storage phù hợp để lưu giữ dữ liệu dài hạn, còn việc tìm kiếm và cảnh báo thời gian thực cần được xử lý bởi công cụ tương ứng.
Cách đẩy log từ server lên Object Storage
Quy trình lưu log lên Object Storage thường gồm ba bước: xoay vòng file log, nén dữ liệu và upload file đã hoàn tất lên bucket. Cách triển khai phụ thuộc vào số lượng server, lượng log phát sinh và độ trễ lưu trữ mong muốn.
1. Luồng logrotate, nén và upload
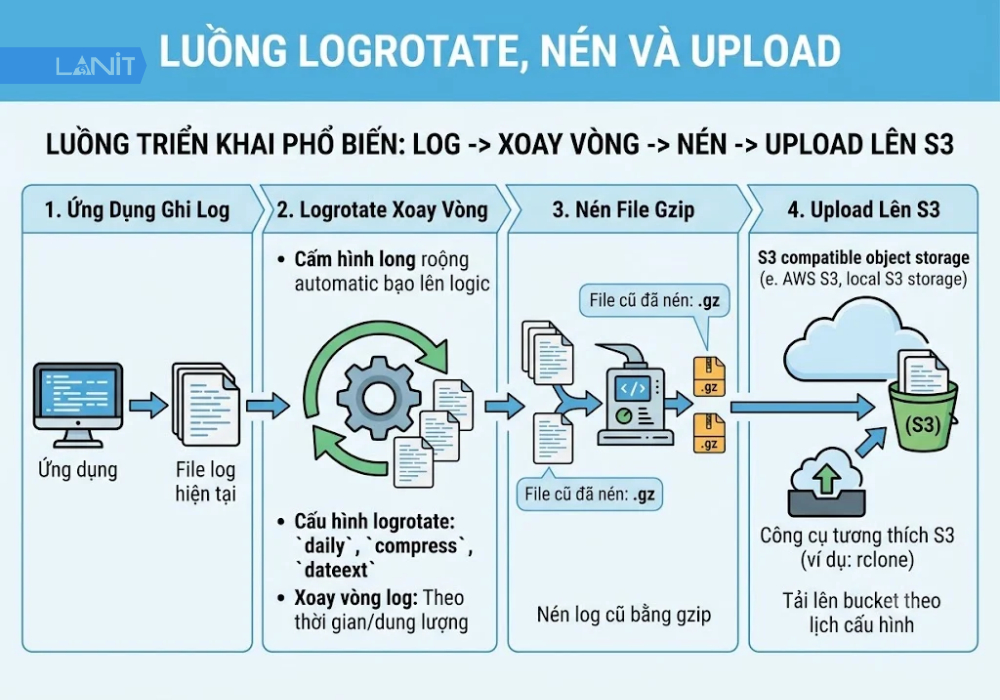
Luồng triển khai phổ biến là ứng dụng tiếp tục ghi log vào file hiện tại, logrotate xoay vòng file theo thời gian hoặc dung lượng, sau đó nén file cũ bằng gzip. Một công cụ tương thích S3 như rclone sẽ upload các file đã nén lên bucket theo lịch được cấu hình.
Trong logrotate, các tùy chọn như daily, compress và dateext giúp kiểm soát chu kỳ xoay vòng, nén file và bổ sung ngày vào tên file. Nhờ đó, log được chia thành từng phần nhỏ, thuận tiện cho việc quản lý và truy xuất khi cần.
2. Xử lý file log đang ghi và xác nhận upload
Chỉ nên upload những file đã hoàn tất ghi và nén. Không nên sao chép file log đang được ứng dụng ghi nếu cần bảo đảm bản lưu trữ chứa đầy đủ dữ liệu tại một thời điểm xác định. Với logrotate, cần kiểm tra cách ứng dụng mở lại file sau khi xoay vòng và chỉ đưa file đã đóng vào danh sách upload.
Tùy chọn –min-age của rclone có thể lọc các file đủ tuổi, nhưng không thay thế việc xác định file đã hoàn tất xử lý. Ví dụ dưới đây minh họa việc upload file gzip cũ hơn một giờ vào một prefix cố định:
rclone copy /var/log/nginx \
  s3-logs:logs-prod/prod/nginx/web01/ \
  --include "*.gz" \
  --min-age 1h
Trong đó, s3-logs là tên remote đã cấu hình, còn logs-prod là bucket ví dụ. Prefix prod/nginx/web01/ giúp phân biệt môi trường, dịch vụ và máy chủ. Nếu cần chia object theo ngày, hãy tổ chức thư mục nguồn hoặc xây dựng quy tắc tạo đường dẫn dựa trên ngày phát sinh của từng file, thay vì mặc định sử dụng ngày chạy tác vụ.
Sau khi upload, có thể dùng rclone check để đối chiếu dữ liệu nguồn và đích trong phạm vi được hỗ trợ. Cần kiểm tra đúng đường dẫn, quy tắc lọc và kết quả kiểm tra trước khi quyết định dọn file cục bộ. Đồng thời, nên ghi nhận trạng thái tác vụ và phát cảnh báo khi upload hoặc xác minh thất bại. Không xóa file nguồn nếu chưa xác nhận bản lưu trữ đáp ứng yêu cầu và chưa có chính sách xử lý lỗi phù hợp.
3. So sánh upload bằng công cụ S3 với agent thu thập log
Có hai hướng triển khai phổ biến. Lựa chọn phù hợp phụ thuộc vào quy mô hệ thống, lượng log và yêu cầu truy xuất.
| Tiêu chí | Công cụ S3 kết hợp logrotate | Agent thu thập log |
| Công cụ tiêu biểu | rclone, s3cmd, AWS CLI | Fluent Bit, Vector |
| Thiết lập | Đơn giản, phù hợp với quy trình upload theo lịch | Cần cài đặt, cấu hình và theo dõi agent |
| Độ trễ | Phụ thuộc lịch upload, thường theo giờ hoặc theo ngày | Có thể thu thập và chuyển tiếp theo lô nhỏ với độ trễ thấp |
| Quản lý nhiều server | Thường phải duy trì cấu hình và lịch chạy trên từng server | Có thể chuẩn hóa cấu hình và quản lý tập trung |
| Tài nguyên | Phát sinh tải khi nén, kiểm tra và upload | Cần tài nguyên cho tiến trình chạy thường trực |
| Phù hợp | Ít server, log được lưu theo đợt | Nhiều server, cần chuẩn hóa hoặc tập trung dữ liệu |
Khuyến nghị: Nếu chỉ có vài server và mục tiêu chính là lưu log dài hạn theo ngày, logrotate kết hợp công cụ S3 thường là phương án đơn giản, dễ vận hành. Khi hệ thống có nhiều server, lượng log lớn hoặc cần thu thập và chuẩn hóa log tập trung với độ trễ thấp, nên cân nhắc agent. Mốc khoảng 10 server có thể dùng làm tham khảo ban đầu, không phải ngưỡng kỹ thuật bắt buộc.
Tổ chức bucket, định dạng và vòng đời log
Log đẩy lên mà không có quy ước đặt tên và chính sách giữ lại sẽ nhanh chóng thành một đống file khó tìm và tốn dung lượng. Ba nhóm quyết định dưới đây nên chốt ngay từ đầu.
1. Cấu trúc bucket và key theo môi trường, dịch vụ, thời gian
Nên dùng một bucket riêng cho log, tách khỏi bucket media và backup để phân quyền và chính sách vòng đời không chồng chéo. Trong bucket, đặt key theo thứ tự: môi trường, dịch vụ, tên server, rồi đến ngày tháng. Ví dụ:
prod/nginx/web01/2026/10/14/access.log-20261014.gzTrong Object Storage không có thư mục thật, phần đường dẫn chỉ là một phần của key. Dù vậy, cách đặt tên này giúp tìm log theo thời gian rất nhanh, đồng thời cho phép áp dụng chính sách vòng đời và phân quyền riêng theo tiền tố, chẳng hạn log môi trường thử nghiệm được xóa sớm hơn log môi trường chính.
2. Nén, định dạng và quản lý object nhỏ
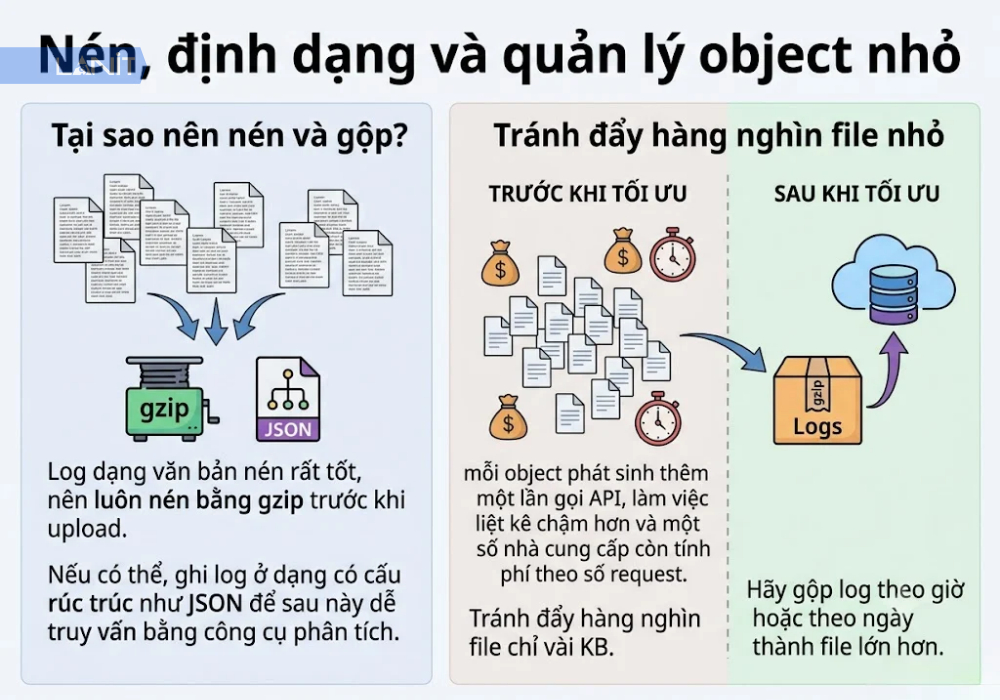
Log dạng văn bản nén rất tốt, nên luôn nén bằng gzip trước khi upload. Nếu có thể, ghi log ở dạng có cấu trúc như JSON để sau này dễ truy vấn bằng công cụ phân tích. Cần tránh đẩy hàng nghìn file chỉ vài KB: mỗi object phát sinh thêm một lần gọi API, làm việc liệt kê chậm hơn và một số nhà cung cấp còn tính phí theo số request. Hãy gộp log theo giờ hoặc theo ngày thành file lớn hơn.
3. Retention, lifecycle và tối ưu chi phí
Thời gian giữ log nên dựa vào mục đích sử dụng và yêu cầu của ngành, không dùng một con số chung cho mọi loại. Ví dụ, tiêu chuẩn PCI DSS (yêu cầu 10.5.1) quy định tổ chức thuộc phạm vi phải giữ lịch sử audit log ít nhất 12 tháng, trong đó 3 tháng gần nhất phải sẵn sàng để phân tích ngay. Hãy kiểm tra xem hệ thống của bạn có thuộc phạm vi tiêu chuẩn nào hay không
Sau khi chốt thời gian giữ, bật chính sách vòng đời (lifecycle) để object tự động bị xóa khi hết hạn, nếu nhà cung cấp hỗ trợ. Khái niệm này được giải thích trong bài cơ chế hoạt động của Object Storage. Để tối ưu chi phí, hãy nén log, gộp object nhỏ và kiểm tra các khoản phí request và phí tải dữ liệu ra trong bảng giá của nhà cung cấp.
Truy xuất log khi có sự cố
Lưu log chỉ thực sự hữu ích khi có thể tìm lại đúng dữ liệu cần thiết để điều tra sự cố. Để tránh tải toàn bộ kho log về server, hãy khoanh vùng theo thời gian, môi trường và nguồn phát sinh trước khi truy xuất các file liên quan.
1. Tìm log theo thời gian và nguồn phát sinh
Với cấu trúc key đã thiết lập, bạn có thể xác định khoảng thời gian xảy ra sự cố, môi trường và server nghi ngờ, sau đó liệt kê các object theo tiền tố tương ứng. Tiếp theo, tải những file cần thiết về máy phân tích, giải nén và tìm nội dung bằng các công cụ như zgrep đối với log văn bản đã nén bằng gzip.
Ví dụ, khi kiểm tra lỗi Nginx trên server web01 trong ngày 14/10/2026, bạn có thể khoanh vùng các object thuộc tiền tố prod/nginx/web01/2026/10/14/ thay vì tải toàn bộ bucket.
Cách này phù hợp khi sự cố không xảy ra thường xuyên và số lượng file cần kiểm tra tương đối nhỏ. Tuy nhiên, việc liệt kê object theo tiền tố chủ yếu giúp xác định file theo cấu trúc lưu trữ, không thể thay thế tìm kiếm theo nội dung. Nếu cần tra cứu hàng triệu dòng log theo IP, mã lỗi, request ID hoặc khoảng thời gian, bạn nên cân nhắc hệ thống truy vấn chuyên dụng.
2. Mô hình hai tầng: hệ thống giám sát và kho log dài hạn
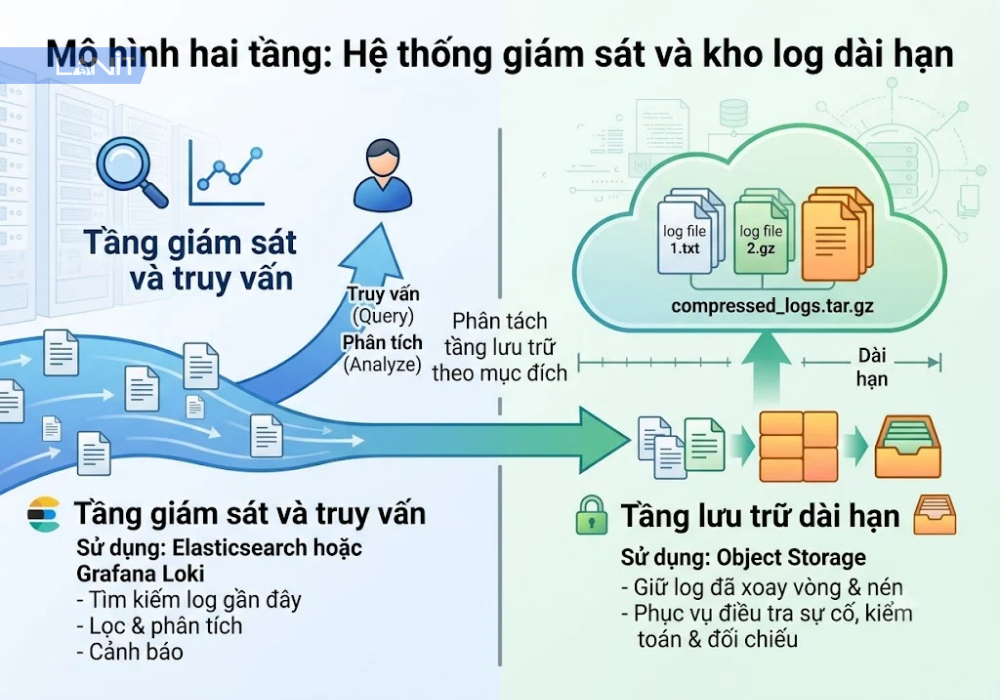
Một mô hình phổ biến là tách log thành hai tầng lưu trữ theo mục đích sử dụng.
- Tầng giám sát và truy vấn: Sử dụng các hệ thống như Elasticsearch hoặc Grafana Loki để tìm kiếm, lọc và phân tích log gần đây, đồng thời hỗ trợ cảnh báo khi được cấu hình phù hợp.
- Tầng lưu trữ dài hạn: Sử dụng Object Storage để giữ các file log đã xoay vòng và nén trong thời gian dài hơn, phục vụ điều tra sự cố, kiểm toán hoặc đối chiếu dữ liệu.
Thời gian giữ log ở mỗi tầng cần được xác định theo nhu cầu truy vấn, ngân sách và yêu cầu tuân thủ. Chẳng hạn, nếu hệ thống cần tra cứu nhanh log trong vài tuần gần nhất nhưng phải lưu lịch sử lâu hơn, bạn có thể giữ dữ liệu trên hệ thống giám sát trong khoảng thời gian ngắn hơn và lưu bản lưu trữ trên Object Storage theo chính sách riêng.
Nếu hệ thống thuộc phạm vi PCI DSS, cần đối chiếu yêu cầu lưu giữ và khả năng sẵn sàng phân tích audit log với phiên bản tiêu chuẩn áp dụng. Không nên mặc định rằng mọi hệ thống đều phải áp dụng cùng một thời hạn lưu log.
3. Khi nào cần công cụ truy vấn chuyên dụng?
Nếu thường xuyên truy vấn log của nhiều tháng trên nhiều server, tải file về rồi tìm thủ công sẽ tốn thời gian và khó mở rộng. Trong trường hợp này, có thể cân nhắc các công cụ như Trino hoặc ClickHouse để truy vấn dữ liệu trên Object Storage thông qua connector hoặc cơ chế tích hợp phù hợp.
Để mô hình này hoạt động hiệu quả, log cần có định dạng nhất quán, chẳng hạn JSON hoặc Parquet, cùng quy ước trường dữ liệu và cách phân vùng hợp lý theo thời gian, dịch vụ hoặc môi trường. Cần cấu hình công cụ truy vấn, quyền truy cập và cách đọc dữ liệu tương ứng; việc lưu file trên bucket tương thích S3 không tự động khiến log có thể được truy vấn ngay.
Bảo mật và chống sửa xóa log
Log có thể chứa thông tin quan trọng để điều tra sự cố và xác định hành vi truy cập bất thường. Nếu kẻ tấn công có thể sửa hoặc xóa log sau khi chiếm quyền server, quá trình truy vết sẽ khó khăn hơn. Vì vậy, kho log cần có quyền truy cập độc lập và cơ chế bảo vệ phù hợp với mức độ quan trọng của dữ liệu.
1. Quyền ghi, quyền đọc và quyền xóa
Nên áp dụng nguyên tắc quyền tối thiểu và tách biệt quyền theo vai trò. Ví dụ:
- Server gửi log: Chỉ được ghi vào tiền tố tương ứng với môi trường hoặc máy chủ của mình, không được đọc dữ liệu không liên quan hoặc tự ý xóa log đã lưu.
- Đội vận hành: Được đọc và truy xuất log theo nhiệm vụ được giao.
- Tài khoản quản trị: Quản lý chính sách lưu giữ, quyền truy cập và thao tác xóa khi được phê duyệt.
Cách phân quyền này giúp hạn chế thiệt hại nếu thông tin xác thực của một server bị lộ. Tuy nhiên, cần kiểm tra kỹ khả năng ghi đè object, quyền quản lý phiên bản và quyền thay đổi chính sách bucket. Nếu ứng dụng sử dụng cùng một Access Key có quyền quá rộng cho cả upload lẫn quản trị, việc tách quyền trên lý thuyết sẽ không phát huy hiệu quả.
2. Versioning, Object Lock và yêu cầu lưu giữ
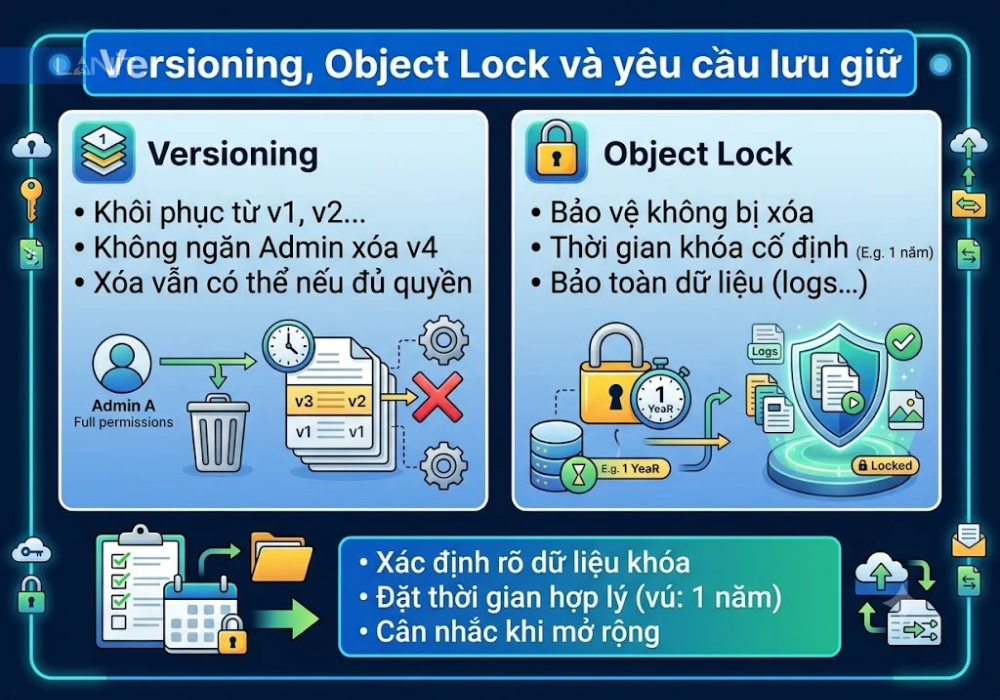
Versioning giữ lại các phiên bản trước khi object bị ghi đè hoặc cập nhật, tùy hành vi và cấu hình của nhà cung cấp. Cơ chế này hỗ trợ khôi phục dữ liệu nhưng không tự ngăn mọi hành vi xóa; các phiên bản cũ vẫn có thể bị xóa nếu tài khoản có đủ quyền và chính sách không hạn chế thao tác đó.
Object Lock cung cấp cơ chế bảo vệ object khỏi việc xóa hoặc ghi đè trong thời hạn quy định. Mức bảo vệ cụ thể phụ thuộc vào chế độ khóa, thời hạn lưu giữ và khả năng hỗ trợ của nhà cung cấp. Vì vậy, cần kiểm tra các điều kiện áp dụng trước khi triển khai, đặc biệt với log phục vụ kiểm toán hoặc yêu cầu bảo toàn bằng chứng.
Trước khi bật Object Lock, hãy xác định rõ thời gian lưu giữ, loại dữ liệu cần khóa và quy trình xử lý khi hết hạn. Cấu hình thời hạn không phù hợp có thể khiến dữ liệu không thể xóa theo kế hoạch.
3. Mã hóa, dữ liệu nhạy cảm và kiểm soát truy cập
Khi truyền log lên Object Storage, hãy sử dụng HTTPS và cấu hình mã hóa dữ liệu khi lưu theo khả năng của nhà cung cấp. Đồng thời, giữ bucket ở chế độ riêng tư, giới hạn quyền truy cập theo vai trò và rà soát định kỳ các Access Key đang được sử dụng.
Log cũng cần được kiểm soát ngay từ nguồn phát sinh. Địa chỉ IP, email, mã phiên và thông tin nhận dạng có thể xuất hiện trong log tùy ứng dụng; đặc biệt, không nên ghi mật khẩu, access token hoặc bí mật xác thực dưới dạng nguyên văn. Hãy lọc hoặc che các trường nhạy cảm trước khi ghi và lưu trữ, đồng thời thiết lập quy trình luân chuyển, thu hồi thông tin xác thực khi có dấu hiệu bị lộ.
Với log quan trọng, nên kết hợp phân quyền tối thiểu, cơ chế bảo vệ khỏi sửa xóa và chính sách lưu giữ phù hợp. Không một biện pháp đơn lẻ nào bảo đảm an toàn tuyệt đối nếu tài khoản quản trị, cấu hình bucket hoặc hệ thống cấp phát thông tin xác thực vẫn có thể bị xâm phạm.
Checklist triển khai lưu log lên Object Storage
Sau khi cấu hình, hãy kiểm tra lần lượt các mục sau để bảo đảm log được lưu đúng nơi, có thể truy xuất và được bảo vệ phù hợp:
- Đã tạo bucket riêng cho log và thiết lập chế độ riêng tư, không cho phép truy cập công khai.
- Key được đặt thống nhất theo môi trường, dịch vụ, server và thời gian phát sinh log.
- Access Key trên server chỉ có quyền cần thiết để upload vào đúng tiền tố; không được tự ý xóa log hoặc thay đổi chính sách bucket.
- Chỉ upload file đã hoàn tất ghi và xoay vòng; đã xác minh kết quả upload trước khi xóa bản cục bộ theo chính sách lưu giữ.
- Đã thiết lập thời gian lưu và lifecycle phù hợp với từng loại log, đồng thời kiểm tra nguy cơ xóa nhầm dữ liệu cần giữ lâu hơn.
- Đã thử tải xuống, giải nén và đọc lại một file log cũ để xác nhận dữ liệu có thể sử dụng khi cần.
- Đã cấu hình ghi nhận trạng thái tác vụ và cảnh báo khi upload hoặc xác minh dữ liệu thất bại.
- Đã kiểm tra cơ chế bảo vệ log khỏi sửa xóa trái phép, chẳng hạn Versioning hoặc Object Lock nếu yêu cầu và nhà cung cấp hỗ trợ.
Câu hỏi thường gặp
Lưu log trên Object Storage có tốn nhiều chi phí không?
Chi phí phụ thuộc ba yếu tố: dung lượng lưu, số request và lượng dữ liệu tải ra. Log chủ yếu là ghi vào và ít khi đọc lại nên thường chỉ chịu chi phí dung lượng. Bạn nên xem bảng giá cụ thể của nhà cung cấp trước khi quyết định.
Nên lưu log bao lâu?
Tùy loại log và yêu cầu của ngành. Log vận hành thường giữ ngắn hơn, log bảo mật và audit giữ lâu hơn. Hãy xác định thời gian dựa trên chính sách nội bộ và các tiêu chuẩn mà hệ thống phải tuân theo.
Có đọc log trực tiếp trên Object Storage được không?
Không mở như một file trên ổ đĩa. Bạn có thể đọc theo luồng mà không cần tải về, ví dụ dùng rclone cat kết hợp zcat, hoặc dùng công cụ truy vấn đọc dữ liệu qua API.
Object Storage có thay thế được hệ thống giám sát log không?
Không. Object Storage là kho lưu trữ, không có tìm kiếm tức thì, dashboard hay cảnh báo. Nó bổ trợ cho hệ thống giám sát bằng cách giữ lịch sử dài hạn.
Log chứa thông tin cá nhân thì xử lý thế nào?
Hạn chế ghi dữ liệu cá nhân ngay từ nguồn, che hoặc băm các trường nhạy cảm, đồng thời kiểm soát truy cập và giới hạn thời gian lưu theo mục đích. Nếu hệ thống thuộc phạm vi quy định về bảo vệ dữ liệu cá nhân, bạn nên trao đổi thêm với bộ phận pháp lý.
Object Storage phù hợp để lưu log khi log đã được xoay vòng và nén, cần giữ lâu và hiếm khi phải đọc lại. Cách làm hiệu quả là kết hợp hai tầng: hệ thống giám sát cho log gần đây, Object Storage cho lịch sử dài hạn. Chất lượng của kho log phụ thuộc vào ba việc: đặt tên key hợp lý, chốt thời gian giữ cùng lifecycle, và phân quyền đủ chặt để log không bị sửa xóa. Nếu bạn cần một lớp lưu trữ riêng cho log, dịch vụ S3 Object Storage của LANIT tương thích chuẩn S3 nên có thể dùng với các công cụ đã nêu trong bài.