
Ngày càng nhiều cá nhân và doanh nghiệp muốn tận dụng AI vào công việc hàng ngày, từ chạy các công cụ automation, chatbot chăm sóc khách hàng, đến tự triển khai mô hình AI mã nguồn mở để kiểm soát dữ liệu tốt hơn. Thay vì đầu tư hàng trăm triệu đồng vào phần cứng riêng, thuê VPS chạy AI đang trở thành lựa chọn phổ biến nhờ chi phí linh hoạt và khả năng nâng cấp nhanh. Nhưng không phải VPS nào cũng phù hợp với mọi tác vụ AI, câu hỏi quan trọng nhất trước khi thuê là: VPS thường có đủ dùng không, hay bắt buộc phải có GPU? Bài viết này sẽ giúp bạn trả lời chính xác câu hỏi đó và chọn đúng cấu hình cho nhu cầu của mình.
Thuê VPS chạy AI là gì?
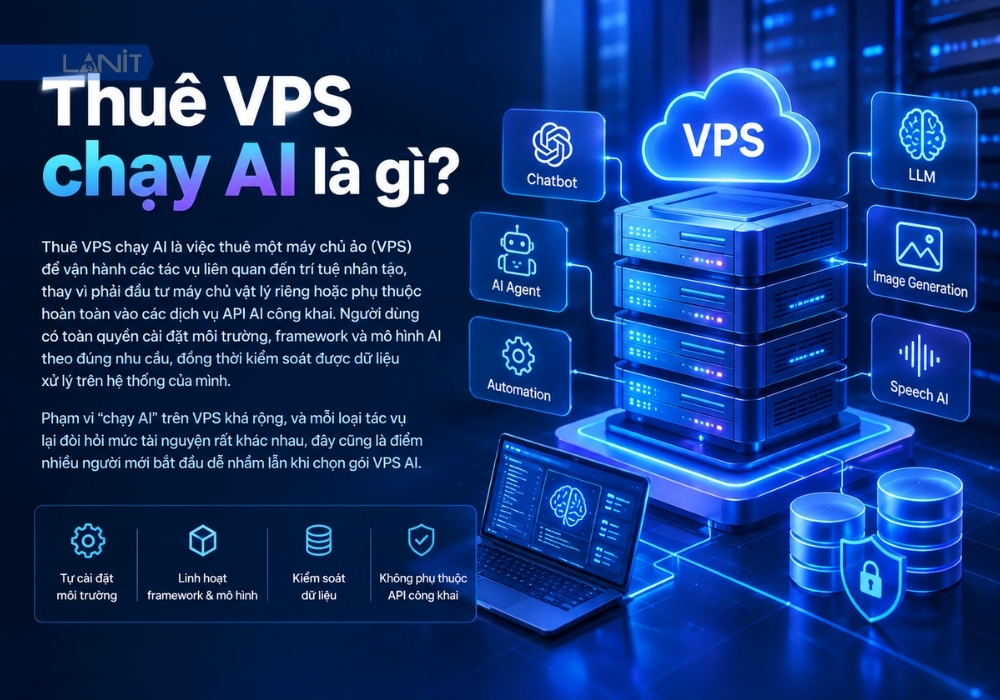
Thuê VPS chạy AI là việc thuê một máy chủ ảo (VPS) để vận hành các tác vụ liên quan đến trí tuệ nhân tạo, thay vì phải đầu tư máy chủ vật lý riêng hoặc phụ thuộc hoàn toàn vào các dịch vụ API AI công khai. Người dùng có toàn quyền cài đặt môi trường, framework và mô hình AI theo đúng nhu cầu, đồng thời kiểm soát được dữ liệu xử lý trên hệ thống của mình.
Phạm vi “chạy AI” trên VPS khá rộng, và mỗi loại tác vụ lại đòi hỏi mức tài nguyên rất khác nhau, đây cũng là điểm nhiều người mới bắt đầu dễ nhầm lẫn khi chọn gói VPS AI.
Các tác vụ AI phổ biến được chạy trên VPS
Không phải tác vụ AI nào cũng yêu cầu VPS có GPU. Cấu hình cần thiết phụ thuộc chủ yếu vào việc VPS chỉ điều phối ứng dụng AI, hay phải trực tiếp thực hiện quá trình suy luận (inference), huấn luyện hoặc xử lý mô hình.
1. Dùng AI thông qua API
Đây là trường hợp phổ biến khi doanh nghiệp dùng n8n, chatbot hoặc ứng dụng nội bộ để gọi các API như OpenAI, Anthropic hoặc Google. Chẳng hạn, một workflow trên n8n có thể nhận email, gửi nội dung tới API AI để phân tích rồi lưu kết quả vào CRM.
Trong mô hình này, VPS chỉ chạy workflow, backend, database và kết nối API. Quá trình tính toán mô hình diễn ra trên hạ tầng của nhà cung cấp AI, nên thường không cần VPS GPU. Cấu hình chủ yếu cần quan tâm là CPU, RAM, SSD và khả năng duy trì kết nối ổn định.
>>>> Đọc thêm bài viết: VPS n8n – Giải pháp tự động hoá linh hoạt và tiết kiệm
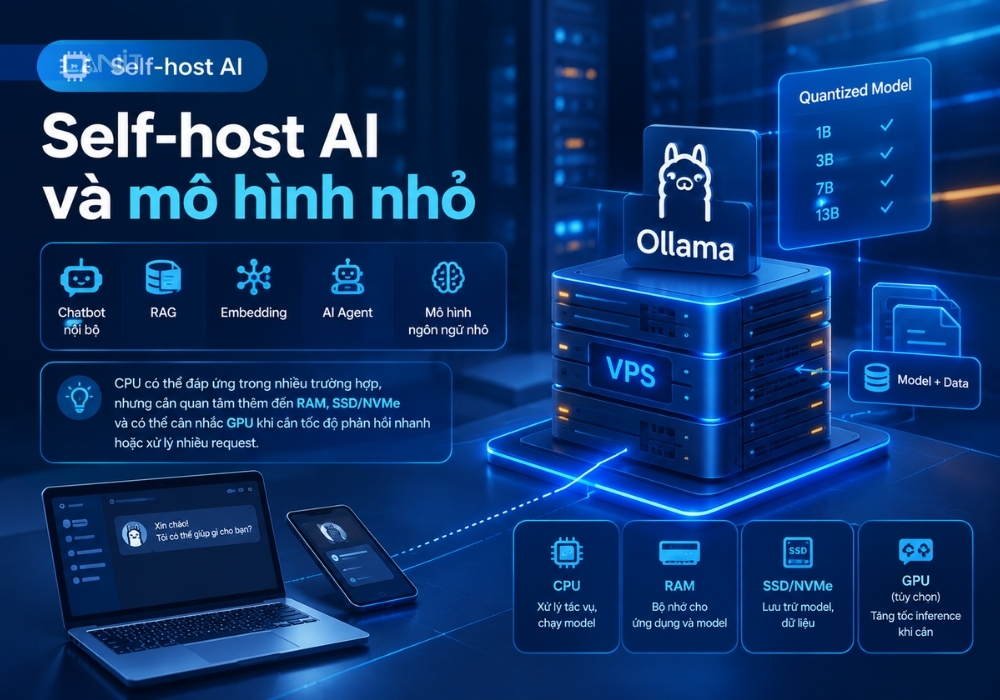
2. Self-host AI và mô hình nhỏ
Nếu muốn tự chạy chatbot nội bộ, RAG, embedding, AI agent hoặc một số mô hình ngôn ngữ nhỏ trên VPS, CPU vẫn có thể đáp ứng trong nhiều trường hợp. Ví dụ, người dùng có thể triển khai Ollama cùng một model đã được quantize để phục vụ một số truy vấn nội bộ với lượng người dùng thấp.
Lúc này, RAM và CPU quan trọng hơn một VPS website thông thường, đồng thời cần đủ dung lượng SSD/NVMe để chứa model và dữ liệu. GPU chưa nhất thiết phải có, nhưng khi yêu cầu phản hồi nhanh hoặc số lượng request tăng lên, GPU có thể giúp cải thiện tốc độ inference.
3. Chạy mô hình lớn trực tiếp trên server
Nhóm này gồm các workload như chạy LLM kích thước lớn, tạo ảnh bằng Stable Diffusion, speech AI hoặc các mô hình xử lý dữ liệu có mức tính toán cao.
Ở đây, GPU thường có vai trò quan trọng vì có khả năng xử lý nhiều phép tính song song. VRAM cũng là thông số cần đặc biệt chú ý, bởi model và các thành phần phục vụ inference phải có đủ bộ nhớ để hoạt động. Không thể chỉ nhìn vào số Core CPU hoặc dung lượng RAM để quyết định một VPS có chạy được model hay không.
Ngoài kích thước model, nhu cầu tài nguyên còn phụ thuộc vào mức quantization, context, batch size và số lượng người dùng đồng thời.
4. Training và fine-tuning
Nếu mục tiêu là huấn luyện mô hình mới hoặc fine-tuning mô hình có sẵn, yêu cầu phần cứng thường cao hơn đáng kể so với inference. Các framework như PyTorch hoặc TensorFlow có thể tận dụng GPU để tăng tốc quá trình tính toán.
Tuy nhiên, không có một cấu hình GPU cố định cho mọi bài toán. Yêu cầu thực tế phụ thuộc vào model, dataset, phương pháp fine-tuning và quy mô training. Với workload lớn, VPS CPU thông thường có thể khiến thời gian xử lý kéo dài và không phù hợp về hiệu quả chi phí.
Cấu hình VPS khuyến nghị theo từng loại tác vụ AI
Không có một cấu hình VPS chạy AI phù hợp cho mọi trường hợp. Cùng là chatbot hoặc LLM nhưng yêu cầu tài nguyên có thể khác nhau đáng kể tùy model, cách triển khai, số người dùng đồng thời và tốc độ phản hồi mong muốn. Bảng dưới đây dùng để ước lượng cấu hình ban đầu, sau đó có thể điều chỉnh theo workload thực tế.
| Tác vụ | Cấu hình tham khảo | GPU/VRAM | Phù hợp với |
| n8n, automation, AI agent, gọi API AI | 2–4 vCPU, 4–8 GB RAM, 50–100 GB SSD/NVMe | Không cần | Workflow tự động, chatbot gọi API, tích hợp AI vào CRM/website |
| Chatbot nội bộ, RAG nhỏ, embedding, model local nhỏ | 4–8 vCPU, 8–16 GB RAM, 100 GB SSD/NVMe trở lên | Không bắt buộc | Thử nghiệm self-host AI, ít người dùng, xử lý không yêu cầu phản hồi quá nhanh |
| LLM local cần phản hồi nhanh | 8 vCPU trở lên, 16–32 GB RAM, SSD/NVMe; ưu tiên GPU có VRAM phù hợp model | Nên có | Chatbot nội bộ, trợ lý AI, API inference có nhiều request |
| AI tạo ảnh, speech hoặc xử lý video | CPU 8 vCPU trở lên, 16–32 GB RAM, SSD/NVMe dung lượng lớn | Thường cần GPU | Stable Diffusion, speech-to-text, text-to-speech, xử lý media bằng AI |
| Training/fine-tuning mô hình | CPU/RAM tùy workload, SSD/NVMe dung lượng lớn, GPU chuyên dụng | Thường cần, VRAM tùy model | Fine-tuning, huấn luyện model, thử nghiệm ML quy mô lớn |
Cách chọn cấu hình theo nhu cầu thực tế
Nếu VPS chỉ dùng để chạy n8n, AI agent hoặc kết nối các API như OpenAI, Anthropic hay Google, không cần trả thêm chi phí cho GPU. Khi đó nên tập trung vào CPU, RAM, SSD/NVMe và độ ổn định của server.
Nếu muốn tự chạy model trên VPS, RAM và dung lượng lưu trữ cần được tính theo model thực tế. Model đã quantize có thể yêu cầu ít tài nguyên hơn bản đầy đủ, trong khi context lớn hoặc nhiều người dùng đồng thời sẽ làm nhu cầu RAM và năng lực xử lý tăng lên.
Với LLM cần phản hồi nhanh, tạo ảnh, speech AI hoặc workload xử lý song song, GPU là thành phần cần được xem xét đầu tiên. Không nên chỉ nhìn vào số Core CPU; cần kiểm tra thêm dung lượng VRAM, model sử dụng bao nhiêu bộ nhớ và số request cần xử lý đồng thời.
Đối với training hoặc fine-tuning, không nên chọn VPS chỉ dựa trên một mức RAM hay VRAM cố định. Model, dataset, phương pháp huấn luyện và framework có thể làm yêu cầu phần cứng thay đổi rất lớn.
Lưu ý: Các mức trên chỉ mang tính tham khảo ban đầu, không phải cấu hình bắt buộc cho từng loại AI. Trước khi thuê VPS, nên xác định model cụ thể, framework, số người dùng đồng thời và yêu cầu về tốc độ phản hồi để chọn cấu hình phù hợp.
Vì sao nên thuê VPS thay vì dùng API AI công khai hoặc tự đầu tư phần cứng
Trước khi quyết định thuê VPS chạy AI, nhiều người vẫn phân vân giữa ba lựa chọn: tiếp tục dùng API AI công khai, tự mua sắm phần cứng, hoặc thuê VPS. Mỗi lựa chọn đều có đánh đổi riêng, nhưng thuê VPS thường mang lại điểm cân bằng tốt nhất cho phần lớn nhu cầu.
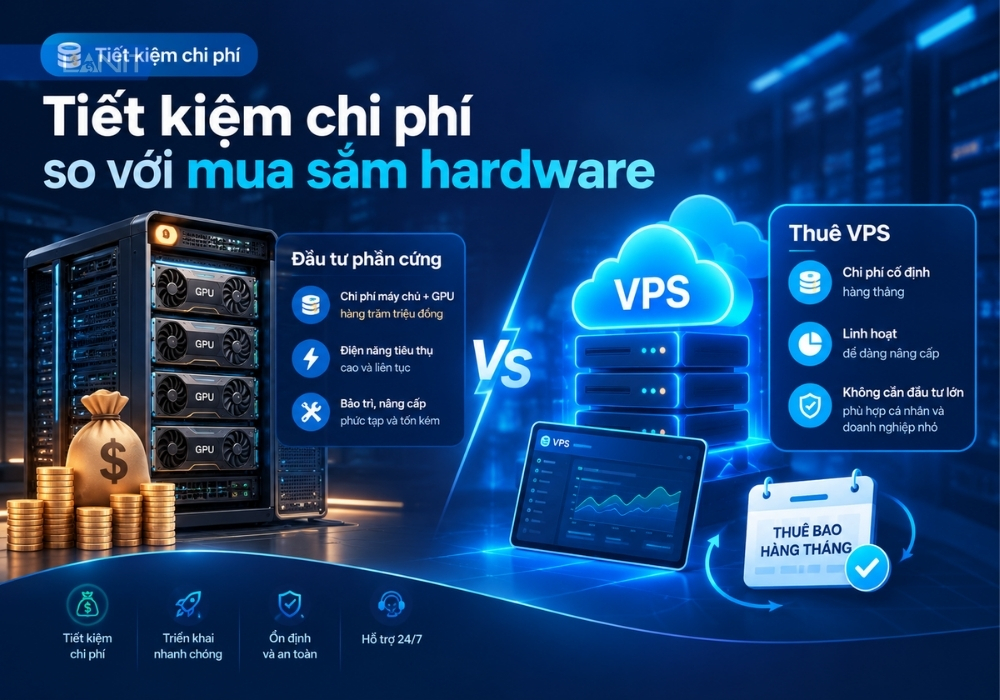
1. Tiết kiệm chi phí so với mua sắm hardware
Đầu tư một bộ máy chủ chuyên dụng cho AI, đặc biệt là các dòng có GPU mạnh, có thể tốn hàng trăm triệu đồng cộng thêm chi phí điện năng và bảo trì. Thuê VPS giúp chuyển khoản đầu tư lớn một lần thành chi phí thuê bao cố định hàng tháng, phù hợp với cả cá nhân lẫn doanh nghiệp nhỏ chưa muốn cam kết vốn dài hạn.
2. Kiểm soát dữ liệu và bảo mật tốt hơn
So với việc gửi dữ liệu qua các API AI công khai, tự vận hành mô hình trên VPS riêng giúp bạn toàn quyền kiểm soát dữ liệu xử lý, đặc biệt quan trọng với các dữ liệu nhạy cảm như thông tin khách hàng hoặc tài liệu nội bộ doanh nghiệp.
3. Linh hoạt nâng cấp cấu hình theo nhu cầu
Khi mới bắt đầu, bạn có thể chọn gói VPS nhỏ để thử nghiệm, sau đó nâng cấp CPU, RAM hoặc chuyển sang gói Cloud Server cao hơn khi nhu cầu tăng, mà không phải tháo dỡ hay thay mới toàn bộ hạ tầng như khi tự đầu tư phần cứng.
Hướng dẫn chọn và bắt đầu thuê VPS chạy AI tại LANIT
Để thuê VPS chạy AI phù hợp, bạn nên bắt đầu từ chính tác vụ cần triển khai thay vì chọn cấu hình theo tên gọi “VPS AI”. Quy trình có thể thực hiện theo 4 bước:
Bước 1: Xác định workload AI cần chạy.
Làm rõ bạn đang dùng AI thông qua API, chạy model trực tiếp trên server, xây dựng chatbot/RAG hay thực hiện inference, fine-tuning. Đây là yếu tố quyết định VPS CPU hay GPU phù hợp.
Bước 2: Xác định tài nguyên cần thiết.
Dựa trên model, số người dùng đồng thời và yêu cầu tốc độ phản hồi để ước lượng CPU, RAM, dung lượng SSD/NVMe và GPU/VRAM nếu cần. Với workload chưa rõ mức tài nguyên, nên chọn cấu hình có khả năng nâng cấp thay vì đầu tư quá cao ngay từ đầu.
Bước 3: Triển khai môi trường AI.
Sau khi thuê VPS, cài hệ điều hành và các thành phần cần thiết như Python, Docker, PyTorch, TensorFlow hoặc framework phù hợp với model. Tiếp đó triển khai ứng dụng, kiểm tra khả năng kết nối và đánh giá tốc độ xử lý trước khi đưa vào vận hành chính thức.
Bước 4: Theo dõi và nâng cấp khi cần.
Trong quá trình sử dụng, theo dõi CPU, RAM, dung lượng lưu trữ và GPU/VRAM để phát hiện tình trạng quá tải. Khi số lượng người dùng hoặc khối lượng xử lý tăng, có thể nâng cấp tài nguyên hoặc thay đổi cấu hình để đáp ứng workload thực tế.
Nếu chưa xác định được cấu hình phù hợp, bạn có thể cung cấp model, framework và mục đích sử dụng cho đội ngũ kỹ thuật LANIT để được tư vấn cấu hình sát với nhu cầu thay vì chọn theo một mức cấu hình chung.
Câu hỏi thường gặp
VPS thường có chạy được AI không? Có, với các tác vụ nhẹ như automation hoặc gọi API AI ngoài, VPS CPU thông thường hoàn toàn đáp ứng tốt.
Cần tối thiểu bao nhiêu RAM để chạy AI trên VPS? Tuỳ tác vụ, nhưng với các tác vụ AI cơ bản nên chọn tối thiểu 8GB RAM trở lên để hệ thống hoạt động ổn định.
Có cần tự cài driver hay phần mềm AI không? Có, với VPS thông thường bạn cần tự cài đặt hệ điều hành, framework và các thư viện AI cần thiết, một số nhà cung cấp có hỗ trợ kỹ thuật trong quá trình này.
Khi nào nên nâng cấp từ VPS lên Cloud Server hoặc Dedicated Server? Khi tác vụ AI đòi hỏi tài nguyên vượt quá khả năng mở rộng của VPS, hoặc cần độ ổn định cao cho môi trường production, bạn nên cân nhắc chuyển sang Cloud Server hoặc thuê máy chủ vật lý riêng.
Chọn thuê VPS chạy AI đúng cách bắt đầu từ việc xác định chính xác tác vụ mình cần, không phải mọi nhu cầu AI đều đòi hỏi GPU, nhưng cũng không nên chọn cấu hình quá thấp cho các tác vụ đòi hỏi tốc độ phản hồi thực tế. Với cách tiếp cận theo từng nhóm tác vụ như trên, bạn có thể tiết kiệm chi phí đáng kể mà vẫn đảm bảo hệ thống AI hoạt động hiệu quả.